Τι αλλάζει όταν ένα AI δεν περιορίζεται στο να προτείνει μια πιθανή λύση, αλλά μπορεί να τη δοκιμάσει σε ένα μοντέλο προσομοίωσης; Η μελέτη LLM Agents Perform Controlled Experiments Using Simulation Models εξετάζει ακριβώς αυτή τη μετάβαση: από τη γλωσσική πιθανότητα σε έναν κύκλο υπόθεσης, παρέμβασης, παρατήρησης και σύγκρισης.
Η σύντομη απάντηση
Οι AI agents γίνονται ουσιαστικά πιο χρήσιμοι όταν δεν περιορίζονται σε μια εύλογη πρόταση, αλλά συγκρίνουν μια baseline συνθήκη με μία ελεγχόμενη παρέμβαση μέσα σε αξιόπιστο simulator. Η προσομοίωση δεν εγγυάται αλήθεια· δημιουργεί όμως συγκεκριμένο evidence που μπορεί να ελεγχθεί από domain expert πριν αλλάξει η πραγματική διαδικασία.
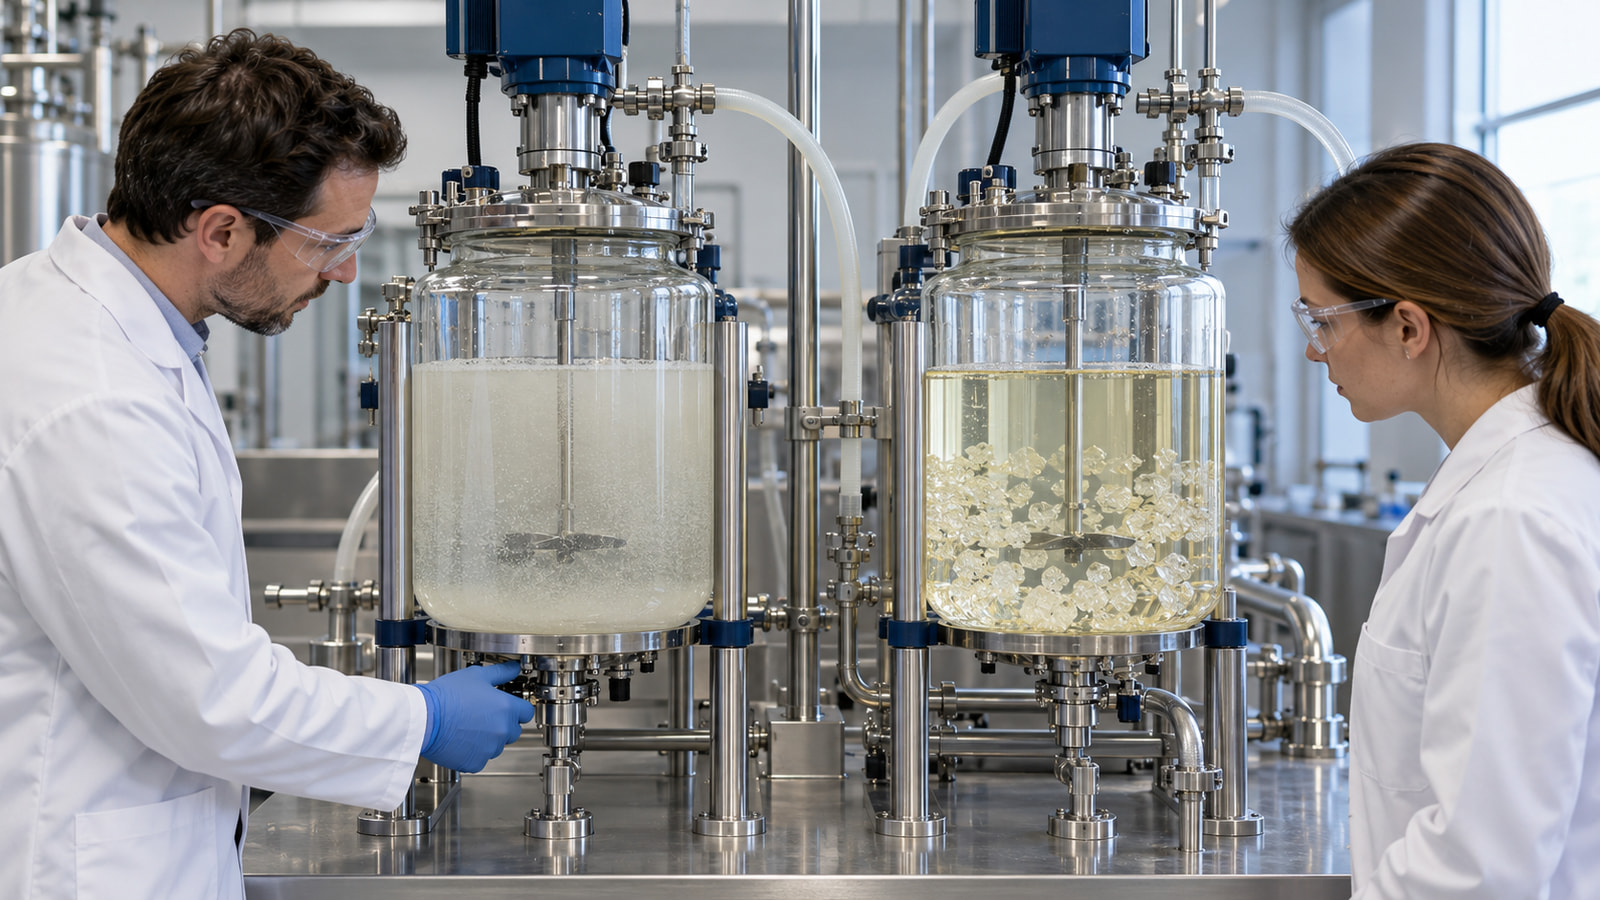
Οι ερευνητές από το University of Stuttgart και την AstraZeneca παρουσιάζουν ένα multi-agent πλαίσιο για τον σχεδιασμό φαρμακευτικών διεργασιών. Το σύστημα παίρνει ένα ερώτημα και μια αρχική διαμόρφωση, αναλύει τις απαιτήσεις, σχεδιάζει ελεγχόμενες μεταβολές, εκτελεί προσομοιώσεις και μετατρέπει τα αποτελέσματα σε τεκμηριωμένες προτάσεις. Η εφαρμογή αφορά την κρυστάλλωση, αλλά η αρχιτεκτονική προσφέρει ένα χρήσιμο μοτίβο για κάθε επιχείρηση που διαθέτει αξιόπιστο simulator ή digital twin.
Γιατί η εύλογη απάντηση δεν αρκεί στην engineering απόφαση
Ένα LLM είναι καλό στο να συνθέτει γλώσσα, να οργανώνει ένα σχέδιο και να χρησιμοποιεί εργαλεία. Σε ένα επιστημονικό ή βιομηχανικό πρόβλημα, όμως, μια καλοδιατυπωμένη σύσταση μπορεί να παραμένει απλώς μια υπόθεση. Η πραγματική ερώτηση είναι πώς αντιδρά το σύστημα όταν αλλάζει μία παράμετρος και οι υπόλοιπες διατηρούνται σταθερές.
Η λογική του ελεγχόμενου πειράματος επιβάλλει πειθαρχία. Πρώτα ορίζεται ένας στόχος. Έπειτα επιλέγεται ένας παράγοντας, εφαρμόζεται συγκεκριμένη παρέμβαση, παρατηρείται η έκβαση και συγκρίνεται με τη γραμμή βάσης. Αυτή η διαδικασία παράγει πιο ελέγξιμα συμπεράσματα από μια απάντηση που βασίζεται αποκλειστικά στη γενική γνώση του μοντέλου.
Η μελέτη δεν ισχυρίζεται ότι η προσομοίωση ισοδυναμεί με το φυσικό πείραμα. Δείχνει ότι ένα υψηλής πιστότητας μοντέλο μπορεί να λειτουργήσει ως περιβάλλον εικονικής εμπειρικής επαλήθευσης, αρκεί να αναγνωρίζονται τα όριά του και η τελική κρίση να παραμένει στον άνθρωπο.
Έξι ρόλοι μετατρέπουν το αίτημα σε πειραματική ροή
Το προτεινόμενο σύστημα αποτελείται από έξι agents. Οι πέντε βασίζονται σε LLM και ο Executor είναι ντετερμινιστικό λογισμικό. Ο Requirement Analyzer μετατρέπει το αίτημα σε σαφή περιγραφή και δομημένες απαιτήσεις. Ο Planner δημιουργεί αφηρημένο σχέδιο, γνωρίζοντας ποιες λειτουργίες προσομοίωσης είναι διαθέσιμες, χωρίς να εφευρίσκει ακόμη λεπτομέρειες εκτέλεσης.
Ο Interactive Operator συγκεκριμενοποιεί τα βήματα και δημιουργεί κώδικα με πλήρως καθορισμένες παραμέτρους. Ο Executor τρέχει τις συναρτήσεις σε ελεγχόμενο περιβάλλον Python και επιστρέφει κείμενο, γραφήματα ή σφάλματα. Ο Interpreter, με δυνατότητα όρασης, διαβάζει τα οπτικά outputs. Τέλος, ο Reporter συγκεντρώνει τα ενδιάμεσα τεκμήρια και συντάσσει την απάντηση για τον μηχανικό.
Η διάσπαση δεν είναι οργανωτικό στολίδι. Διαχωρίζει την κατανόηση της ανάγκης, τον σχεδιασμό, την εκτέλεση και την ερμηνεία. Έτσι μπορεί να εντοπιστεί αν ένα λάθος προήλθε από ασαφή απαίτηση, κακό πλάνο, λανθασμένη κλήση ή παρερμηνεία αποτελέσματος.
Ο βρόχος Operator–Executor–Interpreter και η ανάκαμψη από σφάλματα
Η καρδιά της αρχιτεκτονικής είναι ο διάλογος ανάμεσα στον Operator και τον Executor. Όταν το πλάνο απαιτεί πείραμα, ο Operator παράγει κλήση με συγκεκριμένες τιμές. Ο Executor την εκτελεί και επιστρέφει το αποτέλεσμα. Αν η κλήση είναι ελλιπής ή κακοσχηματισμένη, επιστρέφει μήνυμα σφάλματος, ώστε ο Operator να τη διορθώσει μέχρι να επιτύχει ή να εξαντληθεί προκαθορισμένο όριο προσπαθειών.
Παράλληλα, τα γραφήματα φτάνουν στον Interpreter. Το LLM δεν καλείται να μαντέψει τι θα συνέβαινε· καλείται να ερμηνεύσει συγκεκριμένο output του simulator. Αυτή η διάκριση είναι σημαντική για production AI: άλλο η δημιουργία υπόθεσης και άλλο η ανάγνωση μιας παρατήρησης που προήλθε από εργαλείο.
Για μια εταιρική ομάδα, το αντίστοιχο μοτίβο μπορεί να σημαίνει σαφές contract ανάμεσα σε agent και analytics engine, validation παραμέτρων, καταγραφή κάθε κλήσης και ξεχωριστό στάδιο ερμηνείας. Χωρίς αυτά, η αυτοματοποίηση παραμένει δύσκολο να ελεγχθεί.
Στα πέντε σενάρια της μελέτης, το σύστημα ξεκινά από διάνυσμα παραμέτρων μιας διεργασίας κρυστάλλωσης και έναν στόχο, όπως η μεγιστοποίηση απόδοσης. Επιλέγει σχετικές παραμέτρους, μεταβάλλει μία κάθε φορά και κρατά τις υπόλοιπες σταθερές. Κατόπιν συγκρίνει το αποτέλεσμα της αρχικής κατάστασης με εκείνο της παρέμβασης.
Το simulator είναι ιδιόκτητο βιομηχανικό μοντέλο που συνδυάζει εξισώσεις πρώτων αρχών με ημιεμπειρικές διατυπώσεις και fitted παραμέτρους. Αναπαριστά δυναμικές όπως μεταφορά μάζας, μεταβάσεις φάσης και χρονικά εξελισσόμενες κατανομές υλικού. Οι δυνατότητές του εκτίθενται στους agents ως συναρτήσεις με καθορισμένες προδιαγραφές.
Το κρίσιμο στοιχείο είναι η συγκρισιμότητα. Αν αλλάζουν ταυτόχρονα πολλές παράμετροι, το σύστημα δυσκολεύεται να αποδώσει την έκβαση σε μια συγκεκριμένη αιτία. Η ελεγχόμενη παρέμβαση δεν λύνει κάθε πρόβλημα causal inference, αλλά κάνει την αιτιολόγηση πιο διαφανή από μια ανεξέλεγκτη σειρά ενεργειών.
Το παράδειγμα με το μέγεθος των κρυστάλλων
Η μελέτη παρουσιάζει αίτημα για επίτευξη διάμεσου μεγέθους κρυστάλλου 50 μm. Η έκδοση χωρίς simulation δίνει μια ασφαλή αλλά αβέβαιη πρόταση: υποθέτει ότι η επιβράδυνση της ψύξης μπορεί να επιτρέψει μεγαλύτερη ανάπτυξη των κρυστάλλων.
Το πλήρες σύστημα, αντίθετα, συγκρίνει τις συνθήκες μέσω του simulator. Στο συγκεκριμένο παράδειγμα, υψηλότερος ρυθμός ψύξης 5,25 συνδέθηκε στο output με μεγαλύτερη μάζα στερεάς φάσης API, μεγαλύτερο d50 και στενότερη κατανομή μεγέθους από ρυθμό 3,0. Με βάση αυτή τη σύγκριση, πρότεινε περαιτέρω διερεύνηση υψηλότερου ρυθμού.
Η αξία δεν βρίσκεται μόνο στο ποια επιλογή προτείνεται. Βρίσκεται στο ότι η πρόταση συνοδεύεται από αναγνωρίσιμη σύγκριση. Ο χρήστης μπορεί να δει τη baseline συνθήκη, την παρέμβαση και τη μεταβολή στα outputs, αντί να αντιμετωπίζει μια συμβουλή ως αυθεντία του μοντέλου.
Τέσσερις παραλλαγές απομονώνουν τη συμβολή κάθε μέρους
Οι συγγραφείς συγκρίνουν τέσσερις ρυθμίσεις, όλες με GPT-4o όπου υπάρχει agentic pipeline: το πλήρες σύστημα, έκδοση χωρίς simulation, έκδοση χωρίς Requirement Analyzer και ένα απευθείας LLM-only prompt. Με αυτό τον τρόπο εξετάζουν χωριστά την αξία της προσομοίωσης, της ανάλυσης απαιτήσεων και της πολυ-agent οργάνωσης.
Η αξιολόγηση δεν βασίστηκε μόνο σε αυτόματο judge. Δύο senior domain specialists εξέτασαν τη συλλογιστική και βαθμολόγησαν ορθότητα και χρησιμότητα από 1 έως 5. Οι συγγραφείς αιτιολογούν την επιλογή λέγοντας ότι ένα γενικό LLM judge δεν διαθέτει την εμπειρική γνώση του συγκεκριμένου βιομηχανικού σεναρίου.
Παράλληλα μετρήθηκαν ασαφείς εκφράσεις ανά 1.000 λέξεις, το LUCI uncertainty score, precision και recall των simulation calls, καθώς και το ποσοστό υποθέσεων που επιβεβαιώθηκαν από την προσομοίωση. Έτσι η έρευνα δεν ταυτίζει την καλή γραφή με τη σωστή απόφαση.
Ablation study
Τι αλλάζει όταν αφαιρείται ένα μέρος της αρχιτεκτονικής
Οι τέσσερις ρυθμίσεις ξεχωρίζουν τη συμβολή της προσομοίωσης, της ανάλυσης απαιτήσεων και του agentic workflow.
Τι έδειξαν οι μετρήσεις, και τι δεν αποδεικνύουν
Στα πέντε σενάρια, το πλήρες σύστημα είχε 13,7 ασαφείς λέξεις ανά 1.000 και LUCI 0,13. Η έκδοση χωρίς simulation είχε 51,3 και 0,33 αντίστοιχα, ενώ η LLM-only έκδοση 57,1 και 0,36. Οι ειδικοί έδωσαν στο πλήρες σύστημα μέση ορθότητα 4,1 και χρησιμότητα 4,2. Οι εκδόσεις χωρίς simulation και LLM-only βαθμολογήθηκαν κάτω από 3,0 και θεωρήθηκαν μη αξιοποιήσιμες στο συγκεκριμένο setting.
Το πλήρες σύστημα πέτυχε 94% precision στις κλήσεις προσομοίωσης, 64% recall και 76% επιβεβαίωση υποθέσεων. Χωρίς Requirement Analyzer, το recall αυξήθηκε σε 69%, αλλά το precision έπεσε σε 65% και η επιβεβαίωση σε 45%. Η απουσία σαφών απαιτήσεων οδήγησε σε περισσότερες, αλλά λιγότερο στοχευμένες κλήσεις.
Οι αριθμοί χρειάζονται προσοχή. Η βάση είναι μικρή: πέντε tasks, δύο ειδικοί και ένα συγκεκριμένο proprietary μοντέλο διεργασίας. Τα αποτελέσματα υποστηρίζουν τη χρησιμότητα της αρχιτεκτονικής σε αυτή την εφαρμογή, όχι έναν καθολικό ισχυρισμό ότι κάθε multi-agent σύστημα με simulator θα πετύχει ανάλογη βελτίωση.
Οι βασικές μετρήσεις του πλήρους συστήματος
Μέσοι όροι από πέντε tasks κρυστάλλωσης, με αξιολόγηση δύο senior domain specialists
94%
precision κλήσεων
Οι περισσότερες simulation calls κρίθηκαν κατάλληλες για το ζητούμενο.
64%
recall κλήσεων
Δεν εκτελέστηκαν όλες οι κλήσεις που οι ειδικοί θεώρησαν αναγκαίες.
76%
επιβεβαίωση υποθέσεων
Τρεις στις τέσσερις περίπου υποθέσεις συμφώνησαν με το output του simulator.
4,1 / 4,2
ορθότητα / χρησιμότητα
Οι δύο βαθμολογίες δόθηκαν σε κλίμακα 1 έως 5 από τους domain specialists.
Το αποτέλεσμα δεν είναι γενικός νόμος
Η αξιολόγηση περιλαμβάνει πέντε tasks, δύο ειδικούς και ένα proprietary μοντέλο κρυστάλλωσης. Οι μετρήσεις τεκμηριώνουν το συγκεκριμένο σύστημα και δικαιολογούν νέο validation σε κάθε άλλο simulator, κλάδο και επιχειρησιακό κόστος λάθους.
Τα reasoning graphs ως εργαλείο παρατηρησιμότητας
Η ροή αναπαρίσταται ως κατευθυνόμενο γράφημα. Οι κόμβοι περιλαμβάνουν task descriptions, requirements, planning steps, simulation calls και outputs. Οι ακμές δηλώνουν σχέσεις όπως derives, motivates, yields και summarized. Αυτό δημιουργεί μια ορατή τροχιά από το αρχικό αίτημα έως την τελική σύσταση, την ίδια ανάγκη που καλύπτει η παρατηρησιμότητα των AI agents μέσα από τις καταστάσεις και τις μεταβάσεις τους.
Για μια ομάδα compliance ή quality assurance, η αξία ενός τέτοιου γραφήματος είναι προφανής: μπορεί να εξετάσει ποια απαίτηση κινητοποίησε ένα πείραμα, ποια κλήση παρήγαγε ένα γράφημα και ποιο evidence μπήκε στην αναφορά. Δεν ισοδυναμεί με απόδειξη ορθότητας, αλλά μειώνει το μαύρο κουτί της διαδικασίας.
Στο marketing, στο e-commerce ή στο customer experience, το ίδιο concept μπορεί να εφαρμοστεί μόνο όταν υπάρχει αξιόπιστο μοντέλο του συστήματος. Η πρόβλεψη ενός συστήματος μετά από παρέμβαση απαιτεί να διαχωρίζουμε καθαρά το μοντέλο από την πραγματικότητα που προσπαθεί να αναπαραστήσει. Ένα attribution model ή demand forecast δεν πρέπει να παρουσιάζεται ως φυσικός νόμος. Το reasoning graph πρέπει να διατηρεί και την προέλευση των δεδομένων και τις παραδοχές του μοντέλου.
Η αρχή της διπλής πιστότητας
Η συζήτηση της μελέτης ενοποιεί την ποιότητα κάτω από την έννοια της approximation fidelity. Από τη μία βρίσκεται η φυσική πιστότητα του simulator: κατά πόσο αναπαριστά σωστά την πραγματική δυναμική. Από την άλλη βρίσκεται η ορθότητα της υπόθεσης του LLM: κατά πόσο προτείνει παρέμβαση που οδηγεί προς τον στόχο.
Ένας χαμηλής πιστότητας simulator μπορεί να δώσει ρεαλιστικοφανή αλλά παραπλανητικά στοιχεία. Ένα ανεπαρκές LLM μπορεί να επιλέξει λάθος μεταβλητές ή να αποτύχει να αλληλεπιδράσει σωστά με το εργαλείο. Το ένα μοντέλο δεν θεραπεύει αυτομάτως τις αδυναμίες του άλλου.
Γι’ αυτό οι συγγραφείς τοποθετούν το σύστημα ως assistant για decision support, όχι ως αντικαταστάτη της ανθρώπινης κρίσης. Το σωστό operating model περιλαμβάνει επιβεβαίωση από ειδικούς, όρια χρήσης, versioning του simulator και συνεχή έλεγχο του αν οι εικονικές προβλέψεις συμβαδίζουν με την πραγματικότητα.
Το κριτήριο παραγωγικής χρήσης
Ελέγξτε simulator και agent ως δύο διαφορετικές πηγές σφάλματος
Μια τεκμηριωμένη σύσταση είναι αξιόπιστη μόνο όταν η προσομοίωση παραμένει πιστή στο φυσικό σύστημα και ο agent επιλέγει σωστή παρέμβαση. Κρατήστε versioning, όρια εγκυρότητας, πραγματικές μετρήσεις και ρητή ανθρώπινη έγκριση πριν από κάθε αλλαγή υψηλού αντίκτυπου.
Πώς μεταφράζεται το μοτίβο σε επιχειρηματικό workflow
Μια επιχείρηση που θέλει να εφαρμόσει αυτή τη λογική χρειάζεται πρώτα σαφή baseline και μετρήσιμο στόχο. Έπειτα πρέπει να ορίσει ποιες μεταβλητές επιτρέπεται να αλλάζει ο agent, ποιες παραμένουν σταθερές και ποια outputs θεωρούνται έγκυρα. Οι εργαλειοκλήσεις χρειάζονται schemas, validation και retry policy.
Το επόμενο βήμα είναι η διαχωρισμένη αξιολόγηση. Μετρήστε αν οι κλήσεις ήταν αναγκαίες, αν οι παράμετροι ήταν σωστές, αν οι υποθέσεις επιβεβαιώθηκαν και αν η τελική πρόταση βοήθησε τον χρήστη. Μην χρησιμοποιείτε μόνο linguistic confidence: μια απάντηση με λίγες επιφυλάξεις μπορεί απλώς να είναι υπερβολικά βέβαιη.
Τέλος, κρατήστε τον άνθρωπο στο σημείο όπου το κόστος λάθους είναι ουσιαστικό, με ρητό ρόλο και διαθέσιμο χρόνο για πραγματικό έλεγχο, όπως απαιτεί ένας σωστός human-in-the-loop σχεδιασμός. Το σύστημα μπορεί να οργανώσει το πείραμα και να προτείνει κατεύθυνση, αλλά η έγκριση μιας παραγωγικής αλλαγής απαιτεί domain owner. Η αυτονομία πρέπει να ακολουθεί την επαλήθευση, όχι να προηγείται.
Επτά βήματα για έναν ασφαλή κύκλο agent και simulation
- ZielsetzungΟρίστε την απόφαση και το αποδεκτό αποτέλεσμα
Μετατρέψτε το επιχειρησιακό αίτημα σε μετρήσιμο στόχο, περιορισμούς και σαφή κριτήρια επιτυχίας.
- BaselineΚαταγράψτε την αρχική συνθήκη
Χωρίς σταθερή γραμμή βάσης, ο agent δεν μπορεί να αποδώσει τη διαφορά σε συγκεκριμένη παρέμβαση.
- ΜεταβλητέςΕπιτρέψτε μία ελεγχόμενη αλλαγή κάθε φορά
Ορίστε ποια inputs μπορεί να μεταβάλει ο agent, τα επιτρεπτά εύρη τους και ποιες τιμές πρέπει να παραμένουν σταθερές.
- ContractΤυποποιήστε τις κλήσεις προς τον simulator
Χρησιμοποιήστε schemas, μονάδες μέτρησης, validation και συγκεκριμένα μηνύματα σφάλματος για κάθε function call.
- EvidenceΔιατηρήστε outputs και reasoning provenance
Συνδέστε απαίτηση, υπόθεση, παραμέτρους, αποτέλεσμα και τελική σύσταση ώστε ο domain owner να μπορεί να ανακατασκευάσει τη διαδρομή.
- ValidationΕλέγξτε ξεχωριστά tool use και απόφαση
Μετρήστε precision και recall κλήσεων, επιβεβαίωση υποθέσεων και πραγματική χρησιμότητα, όχι μόνο τη γλωσσική βεβαιότητα.
- ΈγκρισηΚρατήστε τον άνθρωπο πριν από την πραγματική αλλαγή
Η προσομοίωση μπορεί να προτείνει επόμενη δοκιμή· η παραγωγική εφαρμογή χρειάζεται υπεύθυνο, όριο ρίσκου και σχέδιο ανάκαμψης.
Το ουσιαστικό μάθημα για AI προϊόντα
Η πιο χρήσιμη ιδέα της έρευνας είναι ότι η βελτίωση της συλλογιστικής δεν χρειάζεται να προέρχεται μόνο από μεγαλύτερο μοντέλο. Μπορεί να προέρχεται από την αρχιτεκτονική γύρω του: σαφείς απαιτήσεις, ελεγχόμενες παρεμβάσεις, αξιόπιστα εργαλεία, παρατηρήσιμα ενδιάμεσα artifacts και ανθρώπινη αξιολόγηση.
Για τους επαγγελματίες, αυτό αλλάζει το ερώτημα από «ποιο LLM να αγοράσουμε;» σε «ποια απόφαση θέλουμε να ελέγξουμε και ποιο σύστημα μπορεί να παράγει αξιόπιστο evidence;». Όπου υπάρχει υψηλής ποιότητας simulation, το LLM μπορεί να γίνει διεπαφή και orchestrator ενός πειραματικού κύκλου. Σε πεδία όπως η ανακάλυψη υλικών, η καταγραφή κάθε αλλαγής και αποτελέσματος είναι εξίσου κρίσιμη με την ίδια την πρόταση του agent. Όπου δεν υπάρχει, η γλωσσική ευχέρεια δεν πρέπει να βαφτίζεται απόδειξη.
Geschäftsautomatisierung & KI
Σχεδιάστε agentic workflows που δοκιμάζουν πριν ενεργήσουν
Η TWO DOTS συνδέει AI agents με ελεγχόμενα εργαλεία, validation, καταγραφή ενεργειών και ανθρώπινα σημεία έγκρισης, ώστε η αυτοματοποίηση να παράγει ελέγξιμα αποτελέσματα και όχι απλώς πειστικές απαντήσεις.
Häufig gestellte Fragen
Τι σημαίνει ελεγχόμενο πείραμα για έναν AI agent;
Σημαίνει ότι ο agent αλλάζει μία επιλεγμένη παράμετρο, κρατά τις άλλες σταθερές, εκτελεί τον simulator και συγκρίνει το αποτέλεσμα με τη baseline συνθήκη πριν διατυπώσει σύσταση.
Πόσοι ρόλοι χρησιμοποιούνται στο σύστημα της μελέτης;
Χρησιμοποιούνται έξι ρόλοι: Requirement Analyzer, Planner, Interactive Operator, Interactive Executor, Interpreter και Reporter. Οι πέντε είναι LLM-driven, ενώ ο Executor είναι ντετερμινιστικό λογισμικό.
Γιατί χρειάζεται Requirement Analyzer;
Στη μελέτη, η αφαίρεσή του αύξησε το recall των simulation calls από 64% σε 69%, αλλά μείωσε το precision από 94% σε 65% και την επιβεβαίωση υποθέσεων από 76% σε 45%. Οι σαφείς απαιτήσεις περιόρισαν τις άσκοπες κλήσεις.
Μπορεί ο AI agent να αντικαταστήσει έναν μηχανικό;
Όχι σύμφωνα με τη μελέτη. Το σύστημα προτείνεται ως decision-support assistant που παρέχει traceable evidence μέσα στα όρια τόσο του LLM όσο και του simulator, με την τελική κρίση στον domain expert.
Γιατί δεν χρησιμοποιήθηκε LLM-as-a-Judge;
Οι ερευνητές έκριναν ότι ένα γενικό μοντέλο δεν διαθέτει την εμπειρική γνώση του συγκεκριμένου βιομηχανικού σεναρίου. Δύο senior domain specialists αξιολόγησαν ορθότητα και χρησιμότητα σε κλίμακα 1 έως 5.
Τι είναι το simulation confirmation;
Είναι το ποσοστό των υποθέσεων του συστήματος που συμφωνούν με τα outputs της προσομοίωσης και κινούν τη λύση προς τον δηλωμένο στόχο. Στο πλήρες σύστημα ήταν 76%.
Ποιος είναι ο μεγαλύτερος περιορισμός των αποτελεσμάτων;
Η αξιολόγηση αφορά πέντε tasks σε μία φαρμακευτική διεργασία και proprietary simulator. Η μεταφορά της αρχιτεκτονικής σε άλλο κλάδο απαιτεί νέο validation με πραγματικά δεδομένα και domain experts.
Πού μπορεί να εφαρμοστεί επιχειρηματικά αυτό το μοτίβο;
Σε περιβάλλοντα με αξιόπιστο simulator ή digital twin, όπως βιομηχανικές διεργασίες, λειτουργική βελτιστοποίηση και ελεγχόμενες δοκιμές πολιτικών. Δεν είναι κατάλληλο όταν το μοντέλο του συστήματος δεν έχει τεκμηριωμένη πιστότητα.