Mit über 20 Jahren Erfahrung verwandeln wir Ihre digitale Präsenz. Wir sind spezialisiert auf Website- und E-Shop-Entwicklung, SEO und digitales Marketing, ERP-Software und intelligente Automatisierung, die Ihr Unternehmen auf die nächste Stufe heben.
Η αξιόπιστη φωνητική AI κρίνεται στις πραγματικές φωνές και συνθήκες, όχι μόνο στον μέσο όρο.
Ένα σύστημα αναγνώρισης ομιλίας μπορεί να εμφανίζει εξαιρετικό μέσο σκορ και ταυτόχρονα να αποτυγχάνει συστηματικά για συγκεκριμένες φωνές. Αυτό είναι το κεντρικό πρόβλημα που επιχειρεί να κάνει ορατό το Monsoon, η νέα προσθήκη του Voice Arena και του Hugging Face στο Open ASR Leaderboard. Για πρώτη φορά, η πολύγλωσση αξιολόγηση του leaderboard αποκτά γλώσσα του Παγκόσμιου Νότου: τα Hindi. Παράλληλα, προστίθεται ξεχωριστό σύνολο Indian English, ώστε η αγγλική ομιλία της Ινδίας να μην αντιμετωπίζεται σαν μία ενιαία προφορά.
Η αλλαγή δεν αφορά απλώς δύο ακόμη datasets. Αφορά τον τρόπο με τον οποίο ορίζουμε την ποιότητα της φωνητικής τεχνητής νοημοσύνης. Το Monsoon συνδέει κάθε απόσπασμα με στοιχεία για τον ομιλητή, τη γεωγραφία και τη συσκευή, ενώ για τα Hindi αναγνωρίζει ότι περισσότερες από μία γραπτές αποδόσεις μπορεί να είναι σωστές. Για επιχειρήσεις που σχεδιάζουν voice bots, τηλεφωνικά κέντρα, εφαρμογές προσβασιμότητας ή υπηρεσίες σε πολυγλωσσικές αγορές, αυτό είναι ένα πρακτικό μάθημα: ο μέσος όρος δεν αρκεί για να περιγράψει την εμπειρία όλων των πελατών.
Το Word Error Rate, ή WER, είναι ο πιο αναγνωρίσιμος δείκτης για την αυτόματη αναγνώριση ομιλίας. Συγκρίνει το παραγόμενο κείμενο με τη μεταγραφή αναφοράς και καταγράφει αντικαταστάσεις, παραλείψεις και προσθήκες λέξεων. Είναι χρήσιμος, αλλά συμπυκνώνει σε έναν αριθμό πολλές διαφορετικές συνθήκες: ηλικίες, φύλα, προφορές, ρυθμούς ομιλίας, θόρυβο και συσκευές εγγραφής.
Το Open ASR Leaderboard είχε ήδη προσθέσει ιδιωτικά splits, ανάλυση προσαρμογής στο benchmark και βελτιώσεις στους normalisers, ώστε το WER να είναι δυσκολότερο να «παιχτεί». Παρ’ όλα αυτά, το ίδιο το άρθρο του Hugging Face επισημαίνει ότι ένα μόνο σκορ δεν δείχνει πού μοιράζονται άνισα τα λάθη. Το πρόβλημα δεν είναι ότι το leaderboard κρύβει αυτές τις διαφορές· είναι ότι τα περισσότερα test sets καταγράφουν τι ειπώθηκε, αλλά σχεδόν τίποτα για το ποιος το είπε.
Για μια επιχείρηση, η διάκριση είναι κρίσιμη. Ένα μοντέλο μπορεί να πετυχαίνει τον συνολικό στόχο ακρίβειας, αλλά να δυσκολεύει περισσότερο πελάτες μιας περιοχής ή χρήστες φθηνότερων συσκευών. Χωρίς μεταδεδομένα, αυτή η αστοχία χάνεται μέσα στον μέσο όρο και εμφανίζεται αργότερα ως παράπονο, εγκατάλειψη κλήσης ή ανάγκη ανθρώπινης παρέμβασης.
Συνολικό WER · Παρακολούθηση
Δείχνει αν το σύστημα βελτιώνεται συνολικά, αλλά δεν εντοπίζει ποιοι ομιλητές ή ποιες συνθήκες απορροφούν τα περισσότερα λάθη.
TrendΜέσος όρος
Breakdowns · Διάγνωση
Χωρίζουν την απόδοση ανά περιοχή, ηλικία, συσκευή ή ακουστικό περιβάλλον και αποκαλύπτουν αν η ποιότητα μοιράζεται άνισα.
CoverageFailure profile
Business metrics · Εμπειρία
Συνδέουν την ακρίβεια με ολοκλήρωση αιτήματος, επαναλήψεις, μεταφορά σε άνθρωπο και εγκατάλειψη κλήσης.
OutcomeCustomer support
Τέσσερα splits, δύο γλωσσικές πραγματικότητες
Το Monsoon εισάγει τέσσερα speaker-disjoint splits: δημόσιο και ιδιωτικό για Indian English, καθώς και δημόσιο και ιδιωτικό για Hindi. Συνολικά περιλαμβάνουν 4.888 ομιλητές. Το speaker-disjoint design σημαίνει ότι οι ίδιοι ομιλητές δεν επαναλαμβάνονται μεταξύ των splits, περιορίζοντας την πιθανότητα ένα σύστημα να αξιολογείται πάνω σε φωνές που έχει ήδη «δει» σε άλλο μέρος της δοκιμής.
Σύνολο
Dauer
Ομιλητές
Περιοχές
Συσκευές
Indian English public
5,62 ώρες
1.444
428 districts
556
Indian English private
5,58 ώρες
1.405
420 districts
560
Hindi public
1,33 ώρες
468
202 districts
315
Hindi private
4,47 ώρες
1.571
295 districts
582
Τα δεδομένα προέρχονται από αυθόρμητες συνομιλίες δύο ατόμων σε ξεχωριστά κανάλια. Τα clips κόβονται ανά κανάλι, ώστε κάθε απόσπασμα να περιέχει έναν ομιλητή. Η σύνθεση αυτή δεν επιδιώκει πολλές ώρες από λίγους ανθρώπους. Επιδιώκει πολλές διαφορετικές φωνές, γεωγραφίες και καθημερινές συνθήκες, ακόμη κι αν κάθε άτομο συνεισφέρει πολύ λίγο.
Το Monsoon σε τέσσερις τεκμηριωμένους αριθμούς
Οι τιμές περιγράφουν τα τέσσερα συγκεκριμένα evaluation splits και δεν αποτελούν γενικό benchmark για κάθε voice AI προϊόν.
4 splitsδημόσιο και ιδιωτικό για Indian English και Hindi
4.888 ομιλητέςspeaker-disjoint κάλυψη σε όλα τα σύνολα
12 χαρακτηριστικάγια δημογραφία, γεωγραφία, υπόβαθρο και συσκευή
315–582 συσκευέςδιαφορετικά handset models ανά split
Η αξία βρίσκεται στη διακύμανση, όχι μόνο στον όγκο
Οι δημιουργοί περιγράφουν το Monsoon ως μικρό σε ώρες και μεγάλο σε ομιλητές. Περισσότεροι από τους μισούς ομιλητές εμφανίζονται σε ένα μόνο segment. Οι δέκα μεγαλύτεροι contributors αντιστοιχούν μόλις στο 2,8% έως 6,8% της συνολικής διάρκειας, ανάλογα με το subset. Αυτό εμποδίζει λίγες φωνές να καθορίσουν δυσανάλογα το τελικό σκορ.
Η συλλογή σχεδιάστηκε να μεταβάλλεται σε εννέα άξονες: γεωγραφία, ηλικία, φύλο, λεξιλόγιο, συσκευές, ακουστικό περιβάλλον, τύπος ομιλίας, ρυθμός ομιλίας και ύπαρξη πολλαπλών έγκυρων μεταγραφών. Κάθε άξονας αντιστοιχεί σε έναν τρόπο με τον οποίο ο συνολικός μέσος όρος μπορεί να φαίνεται σωστός, αλλά να είναι παραπλανητικός για μια συγκεκριμένη ομάδα.
Οι συμμετέχοντες χρησιμοποίησαν τα δικά τους κινητά και τις δικές τους συνδέσεις, σε εσωτερικούς και εξωτερικούς χώρους. Έτσι, στο dataset διατηρούνται συνθήκες που μοιάζουν περισσότερο με πραγματική χρήση: διαφορετικά μικρόφωνα, ασταθές bandwidth και φυσικός περιβαλλοντικός θόρυβος. Η χαμηλή ποιότητα που έκανε την ομιλία μη κατανοητή αφαιρέθηκε, αλλά ο ρεαλιστικός θόρυβος δεν εξομαλύνθηκε τεχνητά.
Δώδεκα χαρακτηριστικά που κάνουν τα σφάλματα αναλύσιμα
Κάθε segment συνοδεύεται από 18 πεδία, από τα οποία τα 12 είναι μεταδεδομένα. Εκτός από αναγνωριστικό, ήχο, διάρκεια και γλώσσα, καταγράφονται speaker ID, φύλο, ημερομηνία γέννησης, επάγγελμα, εκπαιδευτικό υπόβαθρο, οικογενειακή κατάσταση και εισοδηματική κλίμακα. Προστίθενται επίσης native district, native state, τρέχουσα πόλη, χρόνια παραμονής στην περιοχή, κατασκευαστής και μοντέλο συσκευής.
Αυτά τα πεδία δεν είναι διακοσμητικά. Επιτρέπουν breakdown της απόδοσης ανά ηλικία, εκπαίδευση, επάγγελμα, περιοχή ή handset. Στο Indian English public set εκπροσωπούνται και οι έξι γεωγραφικές ζώνες της χώρας. Στα Hindi, η συγκέντρωση στη λεγόμενη Hindi belt είναι μεγαλύτερη, κάτι που οι δημιουργοί θεωρούν αναμενόμενο για συλλογή που ακολουθεί τον πραγματικό πληθυσμό ομιλητών.
Για ένα e-commerce ή μια υπηρεσία υποστήριξης, αντίστοιχη λογική σημαίνει ότι η δοκιμή πρέπει να πλησιάζει το πραγματικό κοινό. Δεν χρειάζεται να συλλέγονται ευαίσθητα δεδομένα χωρίς σκοπό. Χρειάζεται όμως να σχεδιάζεται, με συγκατάθεση και σωστή διακυβέρνηση, ένα test set που μπορεί να απαντήσει στις επιχειρησιακές ερωτήσεις: λειτουργεί το voice flow στις περιοχές όπου πουλάμε, στις συσκευές που χρησιμοποιούν οι πελάτες και στις ακουστικές συνθήκες μιας πραγματικής κλήσης;
Πώς συλλέχθηκε και ελέγχθηκε το υλικό
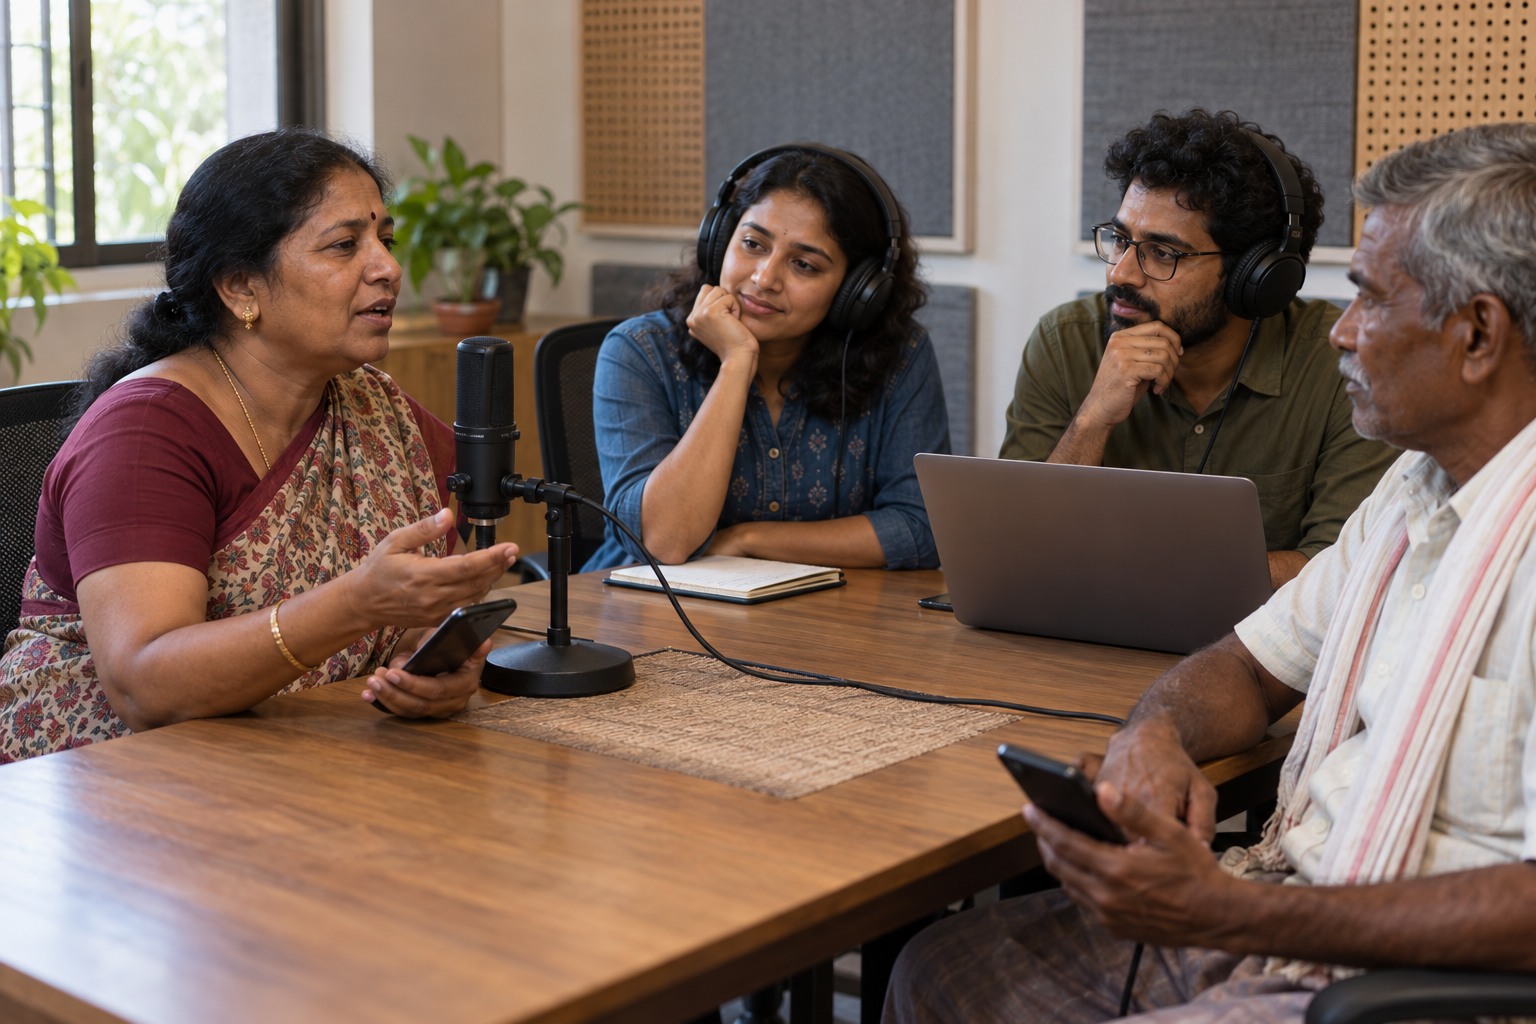
Οι συμμετέχοντες στρατολογήθηκαν μέσω της κοινότητας Voice Arena, η οποία φτάνει και σε αγροτικές ή ημιαστικές περιοχές. Πριν αποκτήσουν πρόσβαση στην εγγραφή, ολοκλήρωσαν έλεγχο γλωσσικής επάρκειας. Οι συνομιλίες ξεκινούσαν από ανοιχτά αφηγηματικά prompts και συνέχιζαν με σταδιακές ερωτήσεις πάνω σε θέματα όπως ταξίδια, υγεία, γεωργία, εκπαίδευση και ψηφιακές υπηρεσίες.
Τα υποψήφια θέματα δημιουργήθηκαν με μεγάλα γλωσσικά μοντέλα, αλλά ελέγχθηκαν και προσαρμόστηκαν από γλωσσολόγους φυσικούς ομιλητές. Η διαδικασία ποιότητας περιλάμβανε επιβεβαίωση της γλώσσας, έλεγχο του δηλωμένου φύλου ως συμπληρωματική επαλήθευση, ανίχνευση προηχογραφημένου ή αναπαραγόμενου ήχου και εκτίμηση signal-to-noise. Μετά, η ομιλία χωρίστηκε με voice activity detection και κάθε segment πέρασε έλεγχο DNSMOS P.808.
Οι μεταγραφές ξεκίνησαν από εσωτερικά ASR μοντέλα που δεν συμμετέχουν στο δημόσιο leaderboard. Στη συνέχεια, γλωσσολόγοι ακολούθησαν πρωτόκολλο πέντε επιπέδων, με διαχωρισμό διόρθωσης και ανεξάρτητης επαλήθευσης. Διαφορετικός annotator έλεγχε κάθε προηγούμενο γύρο, ενώ οι αμφισημίες, τα code-switching σημεία, τα κύρια ονόματα και οι ορθογραφικές παραλλαγές εξετάζονταν επαναληπτικά.
Όταν δύο μοντέλα μοιάζουν ίδια, αλλά δεν είναι
Η πιο καθαρή απόδειξη της χρησιμότητας των μεταδεδομένων βρίσκεται στην περιφερειακή ανάλυση. Οκτώ μοντέλα στο leaderboard πέτυχαν WER από 4,81 έως 4,99 στο δημόσιο Indian English set. Η συνολική απόσταση είναι μόλις 0,18 μονάδες, άρα σε επίπεδο corpus μοιάζουν ουσιαστικά ισοδύναμα.
Όταν όμως οι ομιλητές ομαδοποιούνται ανά γεωγραφική ζώνη, η εικόνα αλλάζει. Το openai/whisper-large-v3-turbo εμφανίζει διακύμανση 0,46 μονάδων μεταξύ ζωνών. Το mistralai/Voxtral-Mini-3B-2507, παρότι βρίσκεται μόλις 0,14 μονάδες πίσω στο συνολικό σκορ, εμφανίζει διακύμανση 1,68: WER 4,38 στην Central zone και 6,06 στην East. Δύο μοντέλα που φαίνονται σχεδόν ίδια στον πίνακα διαφέρουν περίπου τετραπλάσια ως προς την εξάρτηση της ακρίβειάς τους από την περιοχή του ομιλητή.
Δεν υπάρχει μία ζώνη που είναι πάντα η δυσκολότερη. Το ibm-granite/granite-speech-3.3-2b υστερεί περισσότερο στον Βορρά, το microsoft/VibeVoice-ASR-HF στον Νότο και το Voxtral στην Ανατολή. Η διαφορετική κατάταξη των περιοχών ανά μοντέλο δείχνει ότι το ζήτημα δεν εξηγείται απλώς από «δυσκολότερο ήχο». Συνδέεται με το πώς κάθε μοντέλο χειρίζεται διαφορετικά μοτίβα ομιλίας.
Γιατί η ορθογραφία των Hindi απαιτεί διαφορετική μέτρηση
Στα αγγλικά, ένας normaliser μπορεί να ενοποιήσει μεγάλο μέρος των διαφορών σε στίξη, κεφαλαία, αριθμούς ή βρετανική και αμερικανική γραφή. Στα Hindi, η καθημερινή ομιλία περιλαμβάνει έντονο code-mixing, ενώ λέξεις αγγλικής προέλευσης δεν έχουν πάντα μία καθιερωμένη γραφή σε Devanagari. Επίσης, σύνθετες μορφές μπορεί να γράφονται ενωμένες ή χωριστά.
Το άρθρο σημειώνει ότι μία φράση μπορεί να έχει δέκα ή περισσότερες έγκυρες γραπτές μορφές. Με μία μόνο reference transcription, το WER επιβραβεύει το μοντέλο που τυχαίνει να παράγει τη γραφή του annotator, ακόμη κι αν άλλο μοντέλο αναγνώρισε το ίδιο σωστά. Για να αποφευχθεί αυτό, τα Hindi sets διανέμονται με lattice: για κάθε τμήμα της μεταγραφής υπάρχει σύνολο αποδεκτών ορθογραφικών μορφών.
Η αξιολόγηση χρησιμοποιεί Orthographically-Informed Word Error Rate, ή OIWER, από το AI4Bharat. Κάθε υπόθεση ευθυγραμμίζεται με τις αποδεκτές επιλογές και χρεώνονται μόνο τα πραγματικά λάθη αναγνώρισης. Οι δημιουργοί αναφέρουν ότι όταν τα ίδια outputs βαθμολογήθηκαν με μία μόνο αυθαίρετη μορφή, τα error rates αυξήθηκαν για όλα τα συστήματα, αλλά όχι ομοιόμορφα, με αποτέλεσμα να αλλάζει και η κατάταξη.
Δημόσια δεδομένα, ιδιωτική αξιολόγηση και αναπαραγωγιμότητα
Τα δημόσια splits επιτρέπουν self-scoring και ανάλυση. Τα ιδιωτικά splits παραμένουν κρυφά ώστε να περιορίζεται η υπερπροσαρμογή στο benchmark. Για να αξιολογηθεί ένα μοντέλο, ο δημιουργός ανοίγει pull request στο GitHub του Open ASR Leaderboard, δηλώνει αποτελέσματα στα δημόσια datasets και η ομάδα επαληθεύει τα δημόσια σκορ πριν υπολογίσει τα ιδιωτικά.
Το Indian English προστίθεται στο κύριο leaderboard ως Voice Arena Monsoon και συνεισφέρει στο headline Average WER. Τα public και private Hindi εμφανίζονται στην multilingual καρτέλα, όπου ένα μοντέλο κατατάσσεται μόνο αν υποστηρίζει όλες τις επιλεγμένες γλώσσες. Η υλοποίηση του OIWER, με το πακέτο voi-oiwer, είναι επίσης ανοιχτή ώστε τα αποτελέσματα να μπορούν να αναπαραχθούν.
Αυτός ο συνδυασμός είναι ιδιαίτερα χρήσιμος: ανοιχτή μεθοδολογία και δημόσια δεδομένα για έρευνα, αλλά και withheld evaluation για να μην μετατραπεί το benchmark σε άσκηση απομνημόνευσης. Η ίδια αρχή μπορεί να εφαρμοστεί σε εταιρικά evaluations, κρατώντας ένα μέρος των πραγματικών σεναρίων εκτός της καθημερινής βελτιστοποίησης. Το ίδιο μοτίβο εμφανίζεται στο K-Bench για πραγματικές εργασίες AI agents: η μέτρηση έχει αξία όταν ελέγχει το αποτέλεσμα σε συνθήκες που μοιάζουν με παραγωγή.
Τι σημαίνει για προϊόντα voice AI και customer experience
Το επιχειρηματικό συμπέρασμα δεν είναι ότι κάθε εταιρεία πρέπει να αντιγράψει το Monsoon. Είναι ότι το evaluation design αποτελεί μέρος του product design, όπως συμβαίνει και στην αξιολόγηση της πραγματικής συμπεριφοράς των AI agents. Αν ένα voice bot εξυπηρετεί διαφορετικές περιοχές, ηλικίες και συσκευές, το test set πρέπει να περιέχει αρκετή διακύμανση ώστε να αποκαλύπτει πού υποβαθμίζεται η εμπειρία.
Η μέτρηση χρειάζεται τουλάχιστον δύο επίπεδα: συνολικό metric για παρακολούθηση και breakdowns για διάγνωση. Το πρώτο απαντά αν το προϊόν βελτιώνεται κατά μέσο όρο. Το δεύτερο δείχνει ποιος επωφελείται, ποιος μένει πίσω και αν μια νέα έκδοση μεταφέρει το σφάλμα από τη μία ομάδα στην άλλη. Σε περιβάλλον εξυπηρέτησης, αυτά μπορούν να συνδυαστούν με ποσοστό επιτυχούς ολοκλήρωσης, επαναλήψεις, μεταφορά σε agent και εγκατάλειψη.
Η ορθογραφική διάσταση έχει επίσης άμεση εφαρμογή σε πολυγλωσσικό search, catalog matching και transcription. Αν το evaluation δέχεται μία μόνο γραφή για μια λέξη που οι χρήστες γράφουν ή προφέρουν με πολλούς έγκυρους τρόπους, το metric μετρά εν μέρει συμμόρφωση σε μία σύμβαση και όχι κατανόηση. Οι accepted variants πρέπει να σχεδιάζονται με ανθρώπινη γλωσσική κρίση, όπως έγινε στο Monsoon, και όχι να προστίθενται αυτόματα χωρίς έλεγχο.
Ένα πρακτικό πλαίσιο αξιολόγησης για ομάδες προϊόντος
Η εφαρμογή των αρχών του Monsoon σε μια επιχείρηση ξεκινά από το πραγματικό πεδίο χρήσης: γλώσσες, περιοχές, τύπους συσκευών, περιβάλλοντα θορύβου και είδη αιτημάτων. Αν όλοι οι συμμετέχοντες του test set μιλούν σε ήσυχο δωμάτιο με παρόμοιο κινητό, το benchmark δεν μπορεί να αποκαλύψει πρόβλημα σε δρόμο, κατάστημα ή ασταθή σύνδεση.
Το evaluation χρειάζεται να παραμένει μικρό, επαναλήψιμο και συνδεδεμένο με την επιχειρησιακή ροή. Για voice bots και customer support, η TWO DOTS αντιμετωπίζει τέτοιους ελέγχους ως μέρος των Αυτοματισμών Επιχειρήσεων & AI, μαζί με monitoring, ανθρώπινο handoff και σαφή όρια χρήσης.
Έξι βήματα για evaluation που αποκαλύπτει πραγματικές αστοχίες
Schritt 1Χαρτογραφήστε το πραγματικό κοινό και τις συνθήκες
Καταγράψτε γλώσσες, προφορές, περιοχές, συσκευές, περιβάλλοντα θορύβου και είδη αιτημάτων που συναντά το voice flow στην παραγωγή.
Schritt 2Ορίστε υποομάδες πριν δείτε τα αποτελέσματα
Επιλέξτε τα breakdowns που συνδέονται με πραγματικό ρίσκο και εξασφαλίστε επαρκή κάλυψη, ώστε να μην αναζητάτε εκ των υστέρων μόνο τις διαφορές που εντυπωσιάζουν.
Schritt 3Συλλέξτε μόνο τα απαραίτητα μεταδεδομένα
Συνδέστε κάθε πεδίο με σαφή διαγνωστικό σκοπό και εφαρμόστε συγκατάθεση, περιορισμένη πρόσβαση, ελαχιστοποίηση και πολιτική διατήρησης.
Schritt 4Μετρήστε ακρίβεια και επιχειρησιακό αποτέλεσμα
Συνδυάστε WER ή OIWER με ολοκλήρωση αιτήματος, αριθμό επαναλήψεων, χρόνο, μεταφορά σε άνθρωπο και εγκατάλειψη κλήσης.
Βήμα 5Κρατήστε ανεξάρτητο holdout set
Χρησιμοποιήστε ένα ορατό set για γρήγορη επανάληψη και ένα κρυφό set για τελικό έλεγχο, ώστε η βελτιστοποίηση να μη γίνει απομνημόνευση.
Βήμα 6Τρέξτε regression test σε κάθε σημαντική αλλαγή
Καταγράψτε συνολικό score και breakdowns ανά σχετική ομάδα, μαζί με model version, ρυθμίσεις και γνωστά failures, πριν ενεργοποιήσετε νέα έκδοση.
Έτσι, το «βελτιώσαμε το μοντέλο» μετατρέπεται σε ελέγξιμη πρόταση. Η ομάδα βλέπει αν η νέα έκδοση βοηθά συνολικά, αν μεταφέρει το σφάλμα από τη μία ομάδα στην άλλη και πότε απαιτείται rollback ή ανθρώπινη παρέμβαση.
Το ουσιαστικό βήμα: από το ranking στη λογοδοσία
Το Monsoon δεν ισχυρίζεται ότι λύνει τις ανισότητες στην αναγνώριση ομιλίας. Προσθέτει τον μηχανισμό για να γίνουν ορατές. Μεταφέρει την αξιολόγηση από το «ποιο μοντέλο έχει το χαμηλότερο WER;» στο «για ποιους ομιλητές, σε ποιες συνθήκες και με ποιο σύστημα γραφής λειτουργεί καλύτερα;».
Για marketers, product owners και επιχειρήσεις, αυτή είναι μια χρήσιμη μετατόπιση. Η τεχνητή νοημοσύνη δεν αξιολογείται μόνο από το μέσο αποτέλεσμα ενός εργαστηρίου, αλλά από το πόσο συνεπής είναι η εμπειρία των ανθρώπων που τη χρησιμοποιούν. Ένα benchmark με πλούσια, συναινετικά μεταδεδομένα και γλωσσικά δίκαιη αναφορά δεν εγγυάται καλύτερο προϊόν. Προσφέρει όμως την ορατότητα που χρειάζεται για να εντοπιστούν οι πραγματικές αστοχίες πριν περάσουν στον πελάτη.
Από το benchmark στην παραγωγή
Σχεδιάστε voice AI και αυτοματισμούς που ελέγχονται σε πραγματικές συνθήκες
Η TWO DOTS χαρτογραφεί το voice ή support workflow, ορίζει αντιπροσωπευτικά tests, breakdowns και acceptance criteria και συνδέει την αξιολόγηση με monitoring, ανθρώπινο handoff και ασφαλή επαναφορά.
Είναι ανοιχτό leaderboard του Hugging Face για σύγκριση μοντέλων αυτόματης αναγνώρισης ομιλίας σε κοινά datasets και με κοινές διαδικασίες αξιολόγησης.
Τι προσθέτει το Monsoon;
Προσθέτει δημόσια και ιδιωτικά evaluation splits για Indian English και Hindi, με 4.888 speaker-disjoint ομιλητές και 12 χαρακτηριστικά ομιλητή ανά εγγραφή.
Γιατί δεν αρκεί το συνολικό WER;
Επειδή μπορεί να κρύψει μεγάλες διαφορές απόδοσης ανά περιοχή, ηλικία, συσκευή ή ακουστική συνθήκη. Το ίδιο συνολικό σκορ δεν εγγυάται ίδια εμπειρία για όλους.
Τι είναι το OIWER;
Το Orthographically-Informed Word Error Rate συγκρίνει την υπόθεση με ένα σύνολο αποδεκτών ορθογραφικών μορφών και χρεώνει τα πραγματικά λάθη αναγνώρισης, όχι μια διαφορετική αλλά έγκυρη γραφή.
Γιατί υπάρχουν δημόσια και ιδιωτικά splits;
Τα δημόσια επιτρέπουν self-scoring και ανάλυση. Τα ιδιωτικά παραμένουν κρυφά για να περιορίζουν την υπερπροσαρμογή και να προσφέρουν ανεξάρτητο έλεγχο.
Τι έδειξε η περιφερειακή ανάλυση;
Οκτώ μοντέλα απείχαν μόλις 0,18 μονάδες WER συνολικά, αλλά η διακύμανση μεταξύ γεωγραφικών ζωνών έφτασε τις 1,68 μονάδες για ένα από αυτά. Παρόμοιο aggregate score δεν σήμαινε παρόμοια συνέπεια.
Πώς αξιοποιείται η προσέγγιση σε μια επιχείρηση;
Με test sets που αντανακλούν το πραγματικό κοινό, breakdowns ανά σχετική συνθήκη, ελαχιστοποιημένα μεταδεδομένα, κρυφό holdout set και σύνδεση της ακρίβειας με ολοκλήρωση, handoff και εγκατάλειψη.