С повече от 20 години опит ние променяме вашето цифрово присъствие. Специализирани сме в разработването на уебсайтове и електронни магазини, SEO и цифров маркетинг, ERP софтуер и интелигентна автоматизация, които извеждат бизнеса ви на следващото ниво.
Στην edge AI για κλινικό triage, sensitivity, ποιότητα εισόδου και ανθρώπινη παραπομπή πρέπει να ελέγχονται μαζί.
Απάντηση πρώτα: το MobileViTv2 ξεχώρισε επειδή πέτυχε το καλύτερο ισοζύγιο ανάμεσα σε sensitivity, specificity και μικρό αποτύπωμα· όχι επειδή απέδειξε ότι ένα smartphone μπορεί να διαγνώσει καρκίνο στόματος. Το AI screening καρκίνου στόματος της μελέτης αφορά δυαδικό triage εικόνων ως «ύποπτες» ή «μη ύποπτες», με αναφορά σε προσωρινές κλινικές ετικέτες ειδικών.
Στο held-out σύνολο εικόνων, το καλύτερο checkpoint έφτασε sensitivity 87,4%, specificity 86,5% και negative predictive value 97,2%. Τα αποτελέσματα είναι ερευνητικά: το dataset προέρχεται από μία χώρα, δεν υπήρχε patient-level σύνδεση των εικόνων, η ερμηνευσιμότητα αξιολογήθηκε ποιοτικά και δεν έγινε εξωτερική ή prospective κλινική επικύρωση.
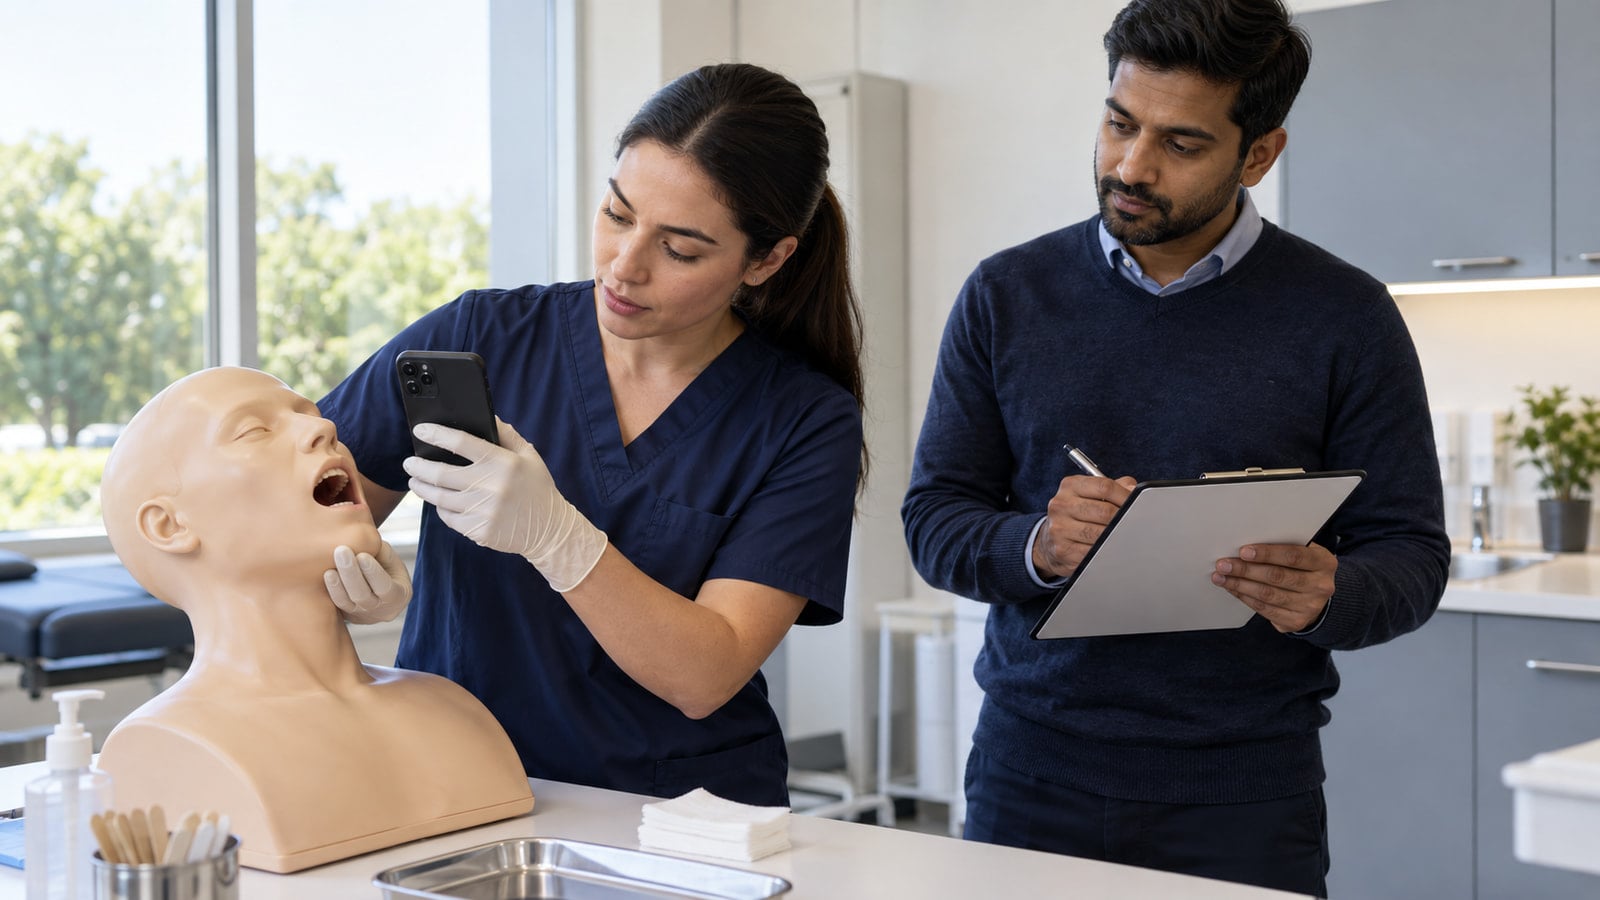
Η εργασία «Robust Lightweight Deep Learning Models for Oral Cancer Screening» εξετάζει αν ένα μικρό μοντέλο όρασης μπορεί να υποστηρίξει triage εικόνων στοματικής κοιλότητας από smartphones. Το ερώτημα είναι τεχνικό και επιχειρησιακό: μπορεί ένα σύστημα με περιορισμένη μνήμη και compute να ξεχωρίζει εικόνες που χρειάζονται παραπομπή, χωρίς να βασίζεται σε cloud υποδομή;
Η έξοδος είναι δυαδική. Η κατηγορία «ύποπτη» περιλαμβάνει βλάβες που απαιτούν παραπομπή, από δυνητικά κακοήθεις διαταραχές έως καρκινώματα, ενώ η «μη ύποπτη» καλύπτει φυσιολογική ανατομία, παραλλαγές και καλοήθεις παρουσιάσεις. Αυτό δεν ισοδυναμεί με ιστολογική διάγνωση, risk stratification ασθενούς ή αντικατάσταση ειδικού.
Η διάκριση έχει σημασία και για το product messaging. Σε AI υψηλού ρίσκου, η περιγραφή πρέπει να ακολουθεί ακριβώς αυτό που αξιολογήθηκε. Η ίδια αρχή εμφανίζεται στην AI για τρισδιάστατη ακτινολογία: ένα χρήσιμο output ή report δεν αποτελεί μόνο του κλινική απόδειξη.
Ερευνητικό αποτέλεσμα
Image-level sensitivity, specificity και NPV σε retrospective held-out δεδομένα με προσωρινές ετικέτες ειδικών.
ΜετρήθηκεRetrospective
Engineering readiness
Μικρό μοντέλο, απλούστερο pipeline και stress tests· χρειάζονται όμως μετρήσεις πάνω στις πραγματικές συσκευές στόχου.
ΥπόσχεσηDevice tests
Κλινική readiness
Απαιτεί εξωτερική και prospective επικύρωση, patient-level splits, πολλούς annotators και ασφαλή ροή παραπομπής.
Δεν αποδείχθηκεHuman oversight
Ένα δεκαετές, πολυκεντρικό dataset εικόνων
Οι εικόνες προήλθαν από προγράμματα της Biocon Foundation σε βόρειες, βορειοανατολικές και νότιες πολιτείες της Ινδίας, από το 2011 έως το 2023. Frontline εργαζόμενοι χρησιμοποίησαν καταναλωτικά smartphones HTC, Motorola, Xiaomi και Samsung με κάμερες 5 έως 16 megapixel. Οι διαφορετικοί αισθητήρες, ο φωτισμός, η εστίαση και οι γωνίες λήψης δεν αφαιρέθηκαν από το πρόβλημα· αποτέλεσαν μέρος του.
Το αρχικό σύνολο είχε 31.601 εικόνες. Μετά την αφαίρεση 126 στατιστικά πανομοιότυπων διπλοτύπων και μη διαγνωστικών λήψεων, παρέμειναν 29.574 εικόνες: 4.887 ύποπτες και 24.687 μη ύποπτες. Ο διαχωρισμός 60%-20%-20% έδωσε 17.744 εικόνες για εκπαίδευση, 5.915 για validation και 5.915 για τελικό test.
Η ποικιλία συσκευών αυξάνει τη ρεαλιστικότητα, αλλά δεν εξαφανίζει το geographic domain shift. Όπως δείχνει η ανάλυση για το πώς ένα AI μοντέλο ταξιδεύει σε νέες αγορές, η επίδοση σε έναν πληθυσμό και ένα δίκτυο συλλογής δεν εγγυάται ίδια συμπεριφορά σε άλλη χώρα, κλινική πρακτική ή κατανομή συσκευών.
Έξι αρχιτεκτονικές για περιορισμένους πόρους
Οι συγγραφείς περιόρισαν την αναζήτηση σε μοντέλα κάτω από 7,5 εκατ. παραμέτρους. Συνέκριναν τα CNN EfficientNetV2-B0, MobileNetV3-Large και NASNet-Mobile, τον transformer DeiT-Ti και τα υβριδικά MobileViTv2 και EdgeNeXt-S. Όλες οι διαμορφώσεις εκπαιδεύτηκαν με ImageNet pretraining, για 50 epochs και batch size 32, ενώ κάθε πειραματική ρύθμιση επαναλήφθηκε δέκα φορές με διαφορετικά σταθερά seeds.
Το MobileViTv2-1.0 είχε 4,9 εκατ. παραμέτρους και είσοδο 256×256. Συνδυάζει τοπική εξαγωγή χαρακτηριστικών μέσω convolutions με ευρύτερο context μέσω attention. Η separable self-attention του έχει γραμμική πολυπλοκότητα ως προς τα tokens, περιορίζοντας το κόστος σε σχέση με την κλασική τετραγωνική self-attention.
Τέσσερις μετρήσεις του συγκεκριμένου MobileViTv2 pipeline
Οι αριθμοί προέρχονται από τη μελέτη και δεν αποτελούν γενική κλινική εγγύηση ή επίδοση σε κάθε smartphone.
29.574 εικόνεςμετά τον καθαρισμό του retrospective dataset
4,9 εκατ.παράμετροι στο MobileViTv2-1.0
17 MBαναφερόμενο μέγεθος των εκπαιδευμένων μοντέλων
97,2%NPV του καλύτερου checkpoint στο συγκεκριμένο test set
Η σχεδιαστική επιλογή είναι χρήσιμη πέρα από την υγεία: η αρχιτεκτονική πρέπει να επιλέγεται μαζί με το περιβάλλον λειτουργίας. Σε edge deployments, bandwidth, latency, κατανάλωση ενέργειας, privacy και δυνατότητα offline λειτουργίας είναι μέρος του model requirement, όχι βελτιστοποιήσεις που προστίθενται στο τέλος.
Γιατί τα augmentations χρειάζονται κλινικό νόημα
Η μελέτη δοκίμασε zoom, αλλαγές χρώματος, flips, μικρές περιστροφές και coarse masks από το Segment Anything Model. Οι γεωμετρικοί μετασχηματισμοί —flips και περιστροφές από -10° έως 10°— έδωσαν την πιο συνεπή βελτίωση. Το colour jitter αντίθετα υποβάθμισε αρκετές αρχιτεκτονικές, επειδή το χρώμα μιας ερυθρής ή λευκής βλάβης μπορεί να είναι κλινικά χρήσιμο σήμα.
Το SAM χρησιμοποιήθηκε μόνο offline στην εκπαίδευση, όχι στο inference. Σε zero-shot λειτουργία, οι coarse masks έκρυβαν συχνά χρήσιμα όρια της στοματικής κοιλότητας. Η αφαίρεσή του απλοποίησε το pipeline και απέφυγε μια απαιτητική εξάρτηση χωρίς σταθερό όφελος.
Δύο no-reference δείκτες ποιότητας, NIQE και CLIP-IQA, χρησιμοποιήθηκαν επίσης για reweighting της loss. Δεν προέκυψε συνολικό πλεονέκτημα. Ένας γενικός δείκτης αισθητικής ή «φυσικότητας» της εικόνας δεν γνωρίζει ποια ατέλεια παραμένει διαγνωστικά χρήσιμη. Το product lesson είναι ότι κάθε proxy metric πρέπει να συνδέεται με τον πραγματικό κίνδυνο και όχι απλώς με οπτική καθαρότητα.
Η ανισορροπία κλάσεων άλλαξε τον στόχο εκπαίδευσης
Η αναλογία ήταν περίπου μία ύποπτη προς πέντε μη ύποπτες εικόνες. Σε τέτοια δεδομένα, ένα υψηλό συνολικό accuracy μπορεί να κρύψει αποτυχία στη μειοψηφική κλάση. Γι’ αυτό οι ερευνητές σύγκριναν random undersampling, random oversampling, weighted cross-entropy, focal loss και balanced Mix-up.
Το undersampling αύξησε τη sensitivity αλλά πέταξε δεδομένα και μείωσε ελαφρά τη specificity. Το oversampling ήταν πιο συντηρητικό, αλλά διόγκωσε το training set. Το balanced Mix-up ανέβασε τη sensitivity σε αρκετές περιπτώσεις, όμως προκάλεσε απότομη πτώση της specificity και περισσότερα ψευδώς θετικά.
Η weighted cross-entropy έδωσε το πιο σταθερό ισοζύγιο. Τα βάρη ορίστηκαν σε 0,60 για τη μη ύποπτη και 3,03 για την ύποπτη κλάση, βάσει αντίστροφης συχνότητας στο training split. Η μέθοδος βελτίωσε τη sensitivity σε όλες τις αρχιτεκτονικές χωρίς το πρόσθετο training burden του oversampling και χωρίς την απώλεια παραδειγμάτων του undersampling.
Τι πέτυχε τελικά το MobileViTv2
Ο συνδυασμός MobileViTv2, γεωμετρικών augmentations και weighted cross-entropy πέρασε σε πενταπλή cross-validation. Η μέση sensitivity ήταν 83,2% με τυπική απόκλιση 1,5 ποσοστιαίας μονάδας και η μέση specificity 86,0% με απόκλιση 0,8. Το καλύτερο checkpoint του πρώτου fold έφτασε sensitivity 87,41% και specificity 86,49%.
Στο ίδιο held-out image set, το checkpoint είχε negative predictive value 97,2% έναντι των ετικετών ειδικών. Η NPV εξαρτάται από την επικράτηση της θετικής κλάσης στον πληθυσμό όπου μετριέται. Δεν πρέπει επομένως να μεταφέρεται μηχανικά σε άλλη χώρα, ηλικιακή ομάδα, κλινική ροή ή συχνότητα νόσου.
Η σωστή ανάγνωση είναι ότι το μοντέλο είχε ισχυρή επίδοση για triage εικόνων μέσα στο συγκεκριμένο retrospective πείραμα. Δεν υπάρχει στο paper patient-level sensitivity, εξωτερικό test set, randomized σύγκριση ροών φροντίδας ή μέτρηση τελικών κλινικών εκβάσεων.
Η επιλογή αρχιτεκτονικής σε κλινικό περιβάλλον δεν αρκεί να είναι τεχνικά βέλτιστη. Η έρευνα για την ATHENA και τη μεταφορά αρχιτεκτονικής μεταξύ νοσοκομείων φωτίζει το ίδιο πρόβλημα από άλλη γωνία: χρειάζεται να ξεχωρίζουμε την επίδοση του μοντέλου από τη γενίκευση του συστήματος.
Γιατί η πολυπλοκότητα δεν κέρδισε
Οι ερευνητές δοκίμασαν knowledge distillation από τρία μεγάλα teacher models: ViT-B/16 περίπου 86 εκατ. παραμέτρων, EfficientNetV2-L περίπου 118 εκατ. και Swin-B περίπου 88 εκατ. Το καλύτερο ισορροπημένο αποτέλεσμα με ViT-B/16 ήταν ανταγωνιστικό, αλλά δεν ξεπέρασε καθαρά την άμεση εκπαίδευση όταν συνυπολογιστούν διακύμανση και κόστος.
Ορισμένες διαμορφώσεις ήταν ασταθείς. Με EfficientNetV2-L και 100% distillation, η μέση sensitivity έπεσε στο 38,16% με πολύ μεγάλη διακύμανση. Με Swin-B και 100% distillation, η sensitivity ανέβηκε στο 86,43%, αλλά η specificity έπεσε στο 62,65%. Οι συγγραφείς συνδέουν τα προβλήματα με διαφορές inductive bias, χωρητικότητας και ανεπαρκές anchoring στα ground-truth labels.
Το αποτέλεσμα δεν σημαίνει ότι το distillation είναι γενικά άχρηστο. Σημαίνει ότι εδώ δεν δικαιολόγησε την πρόσθετη πολυπλοκότητα. Σε production σχεδιασμό, κάθε segmentation βήμα, teacher network ή quality proxy πρέπει να κερδίζει τη θέση του με ablation, failure analysis και μετρήσιμο όφελος στο risk-relevant metric.
Η ερμηνευσιμότητα έδωσε ένδειξη, όχι απόδειξη
Για τον convolutional κλάδο χρησιμοποιήθηκε GradCAM++ και για τα transformer blocks attention rollout στις κλίμακες 16, 64 και 256. Οι οπτικοποιήσεις έδειξαν χωρική ευθυγράμμιση των ενεργοποιήσεων με τις επισημάνσεις ειδικών και εστίαση στην περιοχή της στοματικής κοιλότητας.
Η αξιολόγηση παρέμεινε ποιοτική. Υπήρχαν μόνο 244 specialist-segmented masks, οπότε δεν υπολογίστηκε ποσοτικό metric ερμηνευσιμότητας. Επιπλέον, κάθε εικόνα εξετάστηκε από έναν ειδικό και δεν υπάρχει inter-annotator agreement. Τα heatmaps μειώνουν την ανησυχία ότι κυριαρχεί εμφανώς το φόντο, αλλά δεν αποδεικνύουν κλινικά ορθή αιτιολόγηση.
Τα stress tests αποκάλυψαν κρίσιμο failure mode
Στο held-out test set προστέθηκαν συνθετικά Gaussian, stripe και salt-and-pepper noise. Χωρίς θόρυβο, το καλύτερο μοντέλο είχε sensitivity 87,4% και specificity 86,5%. Με Gaussian noise 20%, η sensitivity παρέμενε 68,8%. Με stripe noise 7%, έπεσε στο 51,7%.
Το πιο ανησυχητικό αποτέλεσμα εμφανίστηκε στο salt-and-pepper noise. Σε ένταση 7%, η sensitivity κατέρρευσε στο 5,1%, ενώ η specificity ανέβηκε τεχνητά στο 99,3%. Το μοντέλο προεπιλεγόταν στη μη ύποπτη κλάση όταν αλλοιώνονταν ακμές και υφές.
Αυτό είναι κλασικό dashboard trap: ένας δείκτης μοιάζει να βελτιώνεται ενώ το σύστημα αποτυγχάνει στον κρίσιμο στόχο. Η παρακολούθηση παραγωγής πρέπει να συνδέει sensitivity, specificity, input-quality gates, κατανομή προβλέψεων, τύπο συσκευής και drift. Το ίδιο failure mode δεν θα φανεί αν το dashboard κρατά μόνο accuracy ή throughput.
Go/no-go για edge AI triage
Καμία «μη ύποπτη» έξοδος χωρίς έλεγχο ποιότητας εισόδου και ασφαλή παραπομπή
Go σημαίνει image-quality gate που έχει επικυρωθεί κλινικά, logging συσκευής και έκδοσης, thresholds ανά πραγματική ροή, παρακολούθηση sensitivity και subgroup performance, ανθρώπινη εποπτεία και fallback όταν η είσοδος βγαίνει έξω από την κατανομή. No-go σημαίνει ασαφής λήψη, άγνωστο device profile, ξαφνική μετατόπιση προβλέψεων ή υψηλή specificity που συνοδεύεται από πτώση της sensitivity.
Τι σημαίνει πραγματικά on-device
Οι συγγραφείς αναφέρουν μοντέλα 17 MB, peak χρήση 1-2 CPU cores για λίγα milliseconds και inference σε λιγότερο από ένα δευτερόλεπτο. Αυτά είναι ενθαρρυντικά engineering claims, αλλά το paper δεν παρουσιάζει benchmark ανά πραγματικό smartphone, μέτρηση ενέργειας, θερμική συμπεριφορά ή prospective εφαρμογή στο πεδίο.
Το μικρό footprint παραμένει ουσιαστικό. Offline inference μπορεί να μειώσει latency, εξάρτηση από συνδεσιμότητα και μεταφορά ευαίσθητων εικόνων στο cloud. Όμως χρειάζεται ολόκληρο product pipeline: camera guidance, quality gate, ασφαλής αποθήκευση, consent, model versioning, crash recovery, ανατροφοδότηση προς τον επαγγελματία και καταγεγραμμένη παραπομπή.
Η αρχιτεκτονική ενός edge συστήματος είναι κάτι περισσότερο από το νευρωνικό δίκτυο. Η περίπτωση του FedOPAL για συνεργατική AI στο edge δείχνει γιατί compute, επικοινωνία και μεταφορά δεδομένων πρέπει να σχεδιάζονται μαζί με το μοντέλο.
Από το paper σε ασφαλές product governance
Πριν από πραγματική χρήση χρειάζονται patient-level splits, εξωτερική επικύρωση σε διαφορετικούς πληθυσμούς και smartphones, πολλοί annotators, μέτρηση συμφωνίας, προκαθορισμένα thresholds και prospective αξιολόγηση μέσα στη ροή φροντίδας. Η απόδοση πρέπει να αναλύεται ανά συσκευή, γεωγραφία, ποιότητα λήψης και υποομάδα, όχι μόνο ως pooled average.
Το FDA Good Machine Learning Practice αντιμετωπίζει την ασφάλεια ως θέμα συνολικού κύκλου ζωής. Το NIST AI RMF ζητά να ενσωματώνονται οι παράγοντες αξιοπιστίας στον σχεδιασμό, την ανάπτυξη, τη χρήση και την αξιολόγηση. Για την ομάδα προϊόντος αυτό μεταφράζεται σε traceable requirements, risk register, data governance, monitoring, change control και σαφή ανθρώπινη ευθύνη.
Η διαφάνεια δεν εξαντλείται σε ένα score ή ένα heatmap. Τα model cards και η διακυβέρνηση AI είναι χρήσιμα όταν καταγράφουν τον intended use, τους απαγορευμένους ισχυρισμούς, τα δεδομένα, τα thresholds, τα failure modes και το πότε το σύστημα πρέπει να παραδώσει την απόφαση σε άνθρωπο.
Επτά έλεγχοι πριν από pilot σε πραγματικό πεδίο
Стъпка 1Κλειδώστε τον ακριβή intended use
Ορίστε αν το προϊόν υποστηρίζει image triage, referral prioritisation ή κάτι άλλο. Απαγορεύστε ρητά claims διάγνωσης ή αντικατάστασης ειδικού που δεν έχουν αξιολογηθεί.
Стъпка 2Χωρίστε δεδομένα σε επίπεδο ασθενούς
Αποτρέψτε leakage μεταξύ training, validation και test και κρατήστε ανεξάρτητο εξωτερικό σύνολο από άλλον πληθυσμό και δίκτυο συλλογής.
Стъпка 3Επικυρώστε την ποιότητα λήψης
Μετρήστε blur, φωτισμό, απόσταση και ορατότητα με κριτήρια που συνδέονται με κλινική χρησιμότητα, όχι με γενική αισθητική εικόνας.
Стъпка 4Δοκιμάστε τις πραγματικές συσκευές στόχου
Καταγράψτε latency, μνήμη, ενέργεια, θερμοκρασία, crashes και επίδοση ανά camera pipeline, λειτουργικό σύστημα και έκδοση εφαρμογής.
Стъпка 5Βαθμονομήστε thresholds στη ροή παραπομπής
Συνδέστε sensitivity, specificity και predictive values με prevalence, χωρητικότητα ειδικών και το πραγματικό κόστος ψευδώς αρνητικών και θετικών.
Стъпка 6Παρακολουθήστε drift και failure signatures
Ελέγξτε input quality, συσκευές, υποομάδες, κατανομή scores και απότομες αποκλίσεις όπως η τεχνητή άνοδος specificity υπό impulse noise.
Стъпка 7Ορίστε handoff, incident response και rollback
Δώστε στον επαγγελματία σαφή λόγο παραπομπής, μηχανισμό override και διαδρομή αναφοράς· κρατήστε δυνατότητα παύσης ή επαναφοράς έκδοσης.
Σε κάθε pilot, τα clinical safety KPIs πρέπει να προηγούνται των vanity metrics. Downloads, inference speed ή adoption δεν απαντούν αν το σύστημα χάνει επικίνδυνες περιπτώσεις. Χρειάζονται audit trail, review επιλεγμένων λαθών και απόφαση go/no-go από κλινικούς, product, data protection και engineering μαζί.
Το μάθημα για ομάδες AI και προϊόντος
Η μελέτη δείχνει ότι ένα μικρό υβριδικό μοντέλο μπορεί να είναι καλύτερη βάση από ένα βαρύτερο pipeline όταν ο στόχος είναι edge deployment. Το MobileViTv2 συνδύασε 4,9 εκατ. παραμέτρους, γεωμετρικά augmentations και weighted cross-entropy με ισχυρή image-level επίδοση στο συγκεκριμένο retrospective dataset.
Ταυτόχρονα, τα όρια είναι ουσιώδη: μία χώρα, αδυναμία patient-level split, ένας specialist ανά εικόνα, 244 segmentation masks, ποιοτική ερμηνευσιμότητα, συνθετικά stress tests και απουσία εξωτερικής ή prospective validation. Το 17 MB είναι θετικό deployment χαρακτηριστικό, όχι πιστοποιητικό κλινικής ετοιμότητας.
Για κάθε ομάδα που αναπτύσσει AI, το χρήσιμο συμπέρασμα είναι να σχεδιάζει αρχιτεκτονική, δεδομένα, metrics και workflow ως ένα σύστημα. Το μικρό μοντέλο κερδίζει μόνο όταν οι έλεγχοι ποιότητας, η ανθρώπινη παραπομπή, η παρακολούθηση drift και η γλώσσα του προϊόντος παραμένουν εξίσου αυστηρά.
Από το ερευνητικό metric σε ελεγχόμενο workflow
Σχεδιάστε AI αυτοματισμούς με μετρήσιμα όρια και ανθρώπινη εποπτεία
Η TWO DOTS χαρτογραφεί intended use, δεδομένα, acceptance tests, monitoring, privacy, handoffs και rollback ώστε ένα AI workflow να παραμένει χρήσιμο και ελέγξιμο πέρα από το demo.
Όχι. Η μελέτη αξιολογεί δυαδικό image triage σε «ύποπτες» και «μη ύποπτες» εικόνες, με αναφορά σε προσωρινές κλινικές ετικέτες. Δεν αποτελεί prospective διαγνωστική δοκιμή ούτε αντικατάσταση ειδικού.
Πόσες εικόνες χρησιμοποιήθηκαν;
Μετά τον καθαρισμό χρησιμοποιήθηκαν 29.574 εικόνες: 4.887 ύποπτες και 24.687 μη ύποπτες. Χωρίστηκαν σε 17.744 training, 5.915 validation και 5.915 test εικόνες.
Γιατί επιλέχθηκε το MobileViTv2;
Το MobileViTv2-1.0, με 4,9 εκατ. παραμέτρους, έδωσε το πιο σταθερό ισοζύγιο sensitivity και specificity. Συνδυάζει τοπικά convolutional χαρακτηριστικά με ευρύτερο context μέσω αποδοτικής attention.
Ποια ήταν η τελική επίδοση;
Στην πενταπλή cross-validation η μέση sensitivity ήταν 83,2% ±1,5 και η specificity 86,0% ±0,8. Το καλύτερο checkpoint έφτασε 87,4% sensitivity, 86,5% specificity και 97,2% NPV στο συγκεκριμένο test set.
Τι σημαίνει NPV 97,2%;
Στο συγκεκριμένο test set, το 97,2% των αρνητικών προβλέψεων του καλύτερου checkpoint αντιστοιχούσε σε μη ύποπτη ετικέτα. Η NPV εξαρτάται από το prevalence και δεν μεταφέρεται αυτούσια σε άλλον πληθυσμό.
Γιατί αφαιρέθηκε το Segment Anything Model;
Τα zero-shot coarse masks έκρυβαν συχνά χρήσιμα όρια της στοματικής κοιλότητας και δεν έδωσαν σταθερό όφελος. Η αφαίρεση του SAM απλοποίησε επίσης το training pipeline.
Ποιο failure mode έδειξαν τα stress tests;
Με salt-and-pepper noise 7%, η sensitivity κατέρρευσε στο 5,1%, ενώ η specificity ανέβηκε τεχνητά στο 99,3%. Το μοντέλο προεπιλεγόταν στη μη ύποπτη κλάση όταν αλλοιώνονταν ακμές και υφές.
Τι λείπει πριν από πραγματική κλινική χρήση;
Χρειάζονται patient-level splits, εξωτερική και prospective επικύρωση, πολλοί annotators, δοκιμές σε πραγματικές συσκευές, subgroup analysis, quality gates και ασφαλής ροή ανθρώπινης παραπομπής.