С повече от 20 години опит ние променяме вашето цифрово присъствие. Специализирани сме в разработването на уебсайтове и електронни магазини, SEO и цифров маркетинг, ERP софтуер и интелигентна автоматизация, които извеждат бизнеса ви на следващото ниво.
Η αξιόπιστη αυτοματοποίηση συνδέει τον παραγόμενο κώδικα με ελεγχόμενη εκτέλεση και μετρήσιμο feedback.
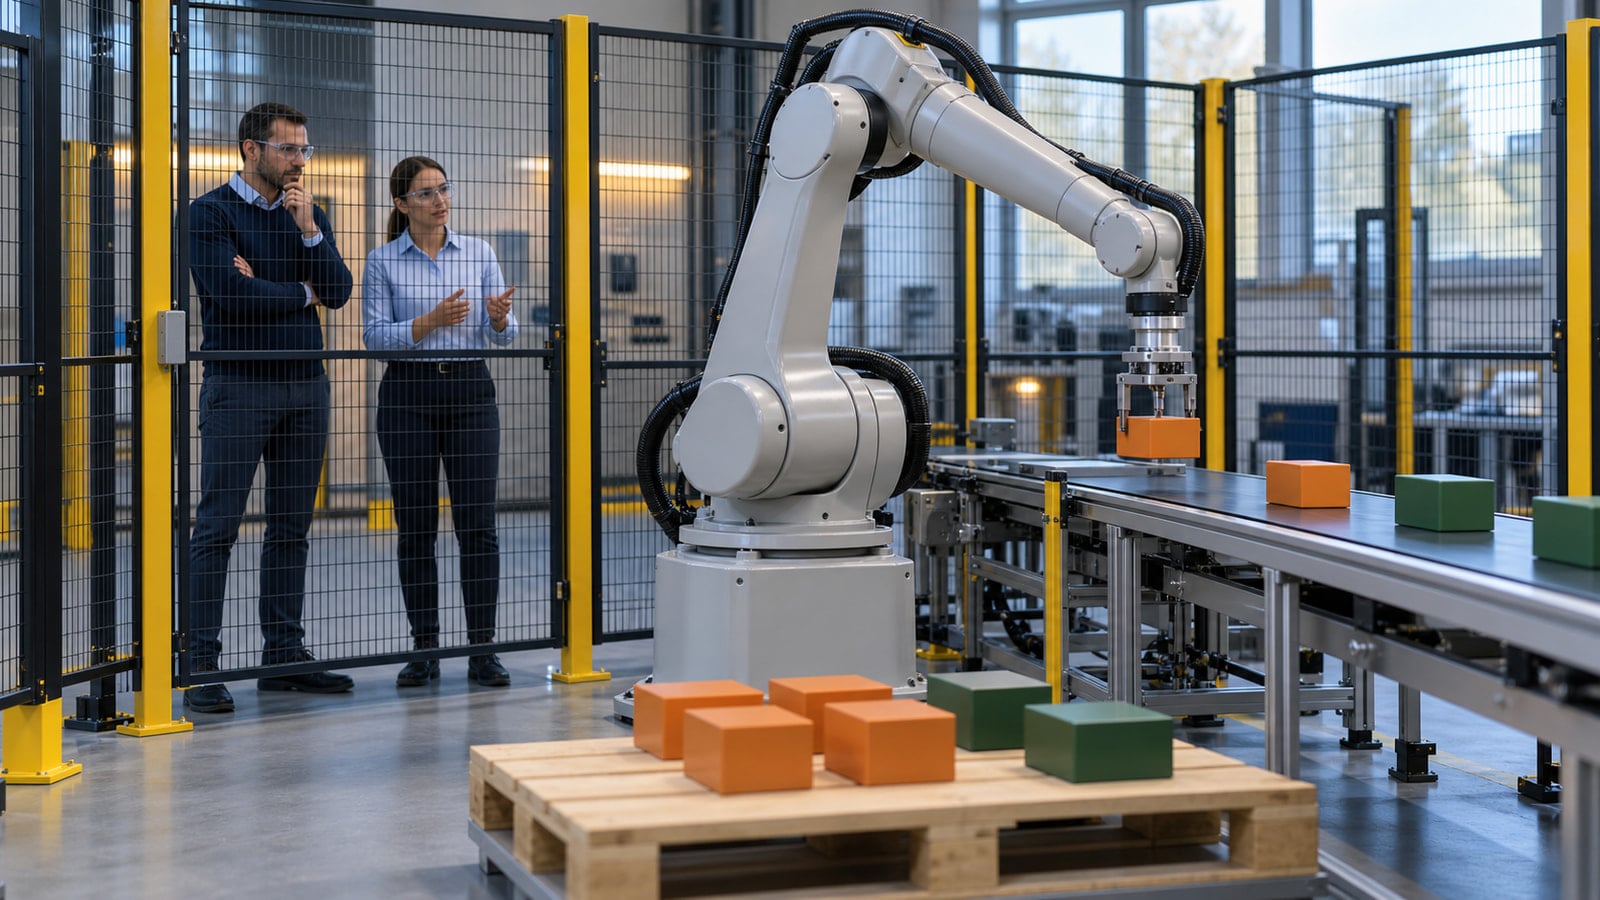
Το MCP και το RAG δεν κάνουν από μόνα τους ασφαλή τη ρομποτική· αποκτούν αξία όταν ο κώδικας που γράφει η AI περνά από τεκμηρίωση, δομικούς ελέγχους, σημασιολογική αξιολόγηση και πραγματική εκτέλεση σε προσομοιωτή. Νέα εργασία του Chalmers University of Technology συνδέει ένα διπλό σύστημα ανάκτησης με το ABB RobotStudio, ώστε παραγόμενα προγράμματα RAPID να δοκιμάζονται σε virtual controller και να διορθώνονται από logs, I/O, joint states και τη γεωμετρία του cell.
Το χρήσιμο επιχειρηματικό μάθημα δεν περιορίζεται στη βιομηχανία. Ένας AI agent που αλλάζει CRM εγγραφές, κανόνες καταλόγου ή ροές παραγγελιών χρειάζεται το ψηφιακό αντίστοιχο του RobotStudio: ελεγχόμενες πηγές, περιορισμένα tools, sandbox ή dry run, observable failure signals και σαφές ανθρώπινο approval πριν από μη αναστρέψιμη ενέργεια.
Η εργασία «Retrieval-grounded robot program generation and simulation-based correction via Model Context Protocol» δημοσιεύθηκε στο arXiv στις 13 Αυγούστου 2026 και έχει γίνει δεκτή στο CIE53. Οι ερευνητές ξεκινούν από ένα πραγματικό bottleneck της ευέλικτης παραγωγής: κάθε αλλαγή προϊόντος, εργαλείου, fixture ή όγκου μπορεί να απαιτεί νέο πρόγραμμα, ενώ η γλώσσα του controller, τα coordinate frames, τα I/O και οι περιορισμοί κίνησης παραμένουν εξειδικευμένη γνώση.
Η προτεινόμενη αρχιτεκτονική δεν ζητά απλώς από ένα LLM να γράψει κώδικα. Ανακτά κανόνες από το τεχνικό υλικό της ABB και δομές από επαληθευμένα παραδείγματα, συνθέτει πλήρες RAPID module, ελέγχει τη δομή και το περιεχόμενό του, το ανεβάζει σε virtual controller και παρατηρεί τι συνέβη. Όταν υπάρχει αποτυχία, τα διαγνωστικά γίνονται context για την επόμενη διόρθωση.
Το εύρος της αξιολόγησης σε τέσσερα μεγέθη
Μετρήσεις της συγκεκριμένης εργασίας· δεν αποτελούν γενικό benchmark για κάθε robot cell, controller ή AI μοντέλο.
106επαληθευμένα RAPID templates
30queries στο retrieval benchmark
21grounded modules στα generation checks
16MCP tools στη γέφυρα της μελέτης
Αυτή η διάταξη θυμίζει ένα ώριμο σύστημα απόδοσης ευθύνης όταν αποτυγχάνει ένας AI agent. Αν το αποτέλεσμα είναι λάθος, η ομάδα μπορεί να ξεχωρίσει αν έφταιξε η ανάκτηση, η παραγωγή κώδικα, το tool contract, η κατάσταση του controller ή μια ιδιότητα της φυσικής σκηνής. Ένα ενιαίο σκορ «accuracy» θα έκρυβε ακριβώς αυτή τη διάκριση.
Γιατί ένα έγκυρο module μπορεί να είναι λάθος
Η RAPID είναι η γλώσσα προγραμματισμού που χρησιμοποιεί ο controller της ABB. Ένα module μπορεί να έχει σωστά delimiters, entry procedure και έγκυρες εντολές, αλλά να μην αναφέρεται στο σωστό tool ή workobject. Μπορεί επίσης να κάνει compile και παρ’ όλα αυτά να στέλνει το ρομπότ σε μη προσβάσιμο στόχο, να επιλέγει προβληματική joint configuration ή να απενεργοποιεί τη βεντούζα σε ύψος που δεν αφήνει το αντικείμενο να αποδεσμευτεί.
Δομικός έλεγχος
Επιβεβαιώνει πλήρες module και procedure, ισορροπημένα delimiters και απουσία placeholders. Αποκλείει σπασμένο output, όχι λανθασμένη γεωμετρία.
ΣύνταξηΠληρότητα
Σημασιολογικός έλεγχος
Εξετάζει εργαλεία, workobjects, I/O signals και την πρόθεση κίνησης. Εντοπίζει ασυμφωνίες με το αίτημα, αλλά δεν εκτελεί το cell.
ΟντότητεςΚανόνες
Simulation feedback
Αποκαλύπτει reachability, release behavior, controller errors και state που υπάρχει μόνο κατά την εκτέλεση στο συγκεκριμένο περιβάλλον.
ΣυμπεριφοράΔιάγνωση
Η διάκριση είναι κρίσιμη και έξω από τη ρομποτική. Ένα JSON payload μπορεί να είναι έγκυρο αλλά να ενημερώνει λάθος πελάτη. Ένας κανόνας τιμολόγησης μπορεί να περνά schema validation αλλά να δημιουργεί αρνητικό περιθώριο. Ένα CRM workflow μπορεί να εκτελείται χωρίς exception αλλά να στέλνει lead σε λάθος ιδιοκτήτη. Για αυτό οι Автоматизация на бизнеса и AI χρειάζονται ελέγχους σε επίπεδο outcome, όχι μόνο σε επίπεδο format.
Η διπλή ανάκτηση: manuals και templates
Το retrieval layer χρησιμοποιεί δύο χωριστές πηγές γνώσης. Το documentation stream βασίζεται κυρίως στο τεχνικό εγχειρίδιο RAPID της ABB και απαντά τι σημαίνουν instructions, functions και data types. Το code-template stream περιέχει 106 επαληθευμένα παραδείγματα RAPID από μεγάλη σκανδιναβική εταιρεία οχημάτων και δείχνει πώς τα επιμέρους στοιχεία συνδυάζονται σε εκτελέσιμη δομή.
Ο διαχωρισμός λύνει διαφορετικά προβλήματα. Τα manuals έχουν υψηλή ακρίβεια ορισμών, αλλά ένα user request όπως «πάρε το κουτί από τον conveyor και τοποθέτησέ το σε τρεις στρώσεις» δεν χρησιμοποιεί απαραίτητα την επίσημη ορολογία. Τα production-style templates γεφυρώνουν αυτό το λεξιλογικό κενό με patterns για κινήσεις, I/O, error handling, εργαλεία και workobjects. Το ίδιο συμβαίνει σε ένα private chatbot με RAG: η πολιτική εξηγεί τι επιτρέπεται, ενώ τα επικυρωμένα παραδείγματα δείχνουν πώς εφαρμόζεται σε πραγματικό αίτημα.
Πριν από την παραγωγή, το αίτημα διασπάται σε μικρότερα retrieval tasks. Τα αποσπάσματα οργανώνονται σε prompt που ζητά πλήρες module, σαφή entry procedure, ισορροπημένα delimiters, απουσία unresolved placeholders και πιστή χρήση των ονομάτων που έδωσε ο χρήστης. Η ποιότητα δεν προκύπτει μόνο από «περισσότερο context», αλλά από σωστό routing ανάμεσα σε πηγή ορισμών και πηγή εφαρμοσμένων patterns.
Το MCP ως ελεγχόμενη γέφυρα προς το RobotStudio
Στην εργασία, ένας προσαρμοσμένος MCP server συνδέει τον client του γλωσσικού μοντέλου με το ABB RobotStudio. Ένα add-in εκθέτει τοπικό HTTP API στη θύρα 8080 και η γέφυρα μεταφράζει typed tool calls σε ενέργειες του RobotStudio SDK και του virtual controller. Το μοντέλο δεν ενσωματώνεται στον simulator και δεν αποκτά αδιαφανή πρόσβαση σε ολόκληρο το σύστημα.
Η έκδοση που αξιολογήθηκε στην εργασία είχε 16 εργαλεία: κατάσταση station, ανάγνωση joints, έλεγχο simulation, upload και execution RAPID, event logs, module/source inspection, RAPID variables, I/O signals, scene objects και screenshots. Αυτή είναι η τεχνική αξία του MCP εδώ: όχι «μαγική» κατανόηση του RobotStudio, αλλά ρητές συμβάσεις εισόδου και εξόδου που κάνουν κάθε ενέργεια παρατηρήσιμη.
Το δημόσιο engineering repository έχει εξελιχθεί μετά το πείραμα και, κατά τον έλεγχο της 13ης Σεπτεμβρίου 2026, τεκμηριώνει 34 MCP tools μαζί με local CLI και πρόσθετα prechecks. Η ίδια τεκμηρίωση επισημαίνει ότι η συμβατότητα του RobotStudio 2025 δεν έχει runtime-tested επιβεβαίωση και η γραμμή 2026.1+ παραμένει πειραματική. Επομένως, οι 16 λειτουργίες της μελέτης είναι το αξιολογημένο σύνολο· οι μεταγενέστερες προσθήκες δεν κληρονομούν αυτόματα τα ίδια evidence.
Η αρχή συνδέεται άμεσα με το WebMCP για ασφαλείς AI agents σε website. Όταν μια εφαρμογή εκθέτει περιορισμένα, ονομασμένα εργαλεία, ο agent δεν χρειάζεται να μαντεύει UI στοιχεία. Αυτό όμως δεν αντικαθιστά authentication, authorization, rate limits, επιβεβαίωση και server-side enforcement. Το MCP tool routing πρέπει να δείχνει στον agent το μικρότερο επαρκές tool surface για κάθε εργασία.
Τι έδειξαν retrieval και code checks
Στο κοινό σύνολο 30 queries, το documentation-only baseline πέτυχε precision 0,52, recall 0,41 και mean reciprocal rank 0,58. Με την προσθήκη του stream των code templates, οι τιμές έγιναν 0,68, 0,57 και 0,72 αντίστοιχα. Η σύγκριση είναι έγκυρη μέσα σε αυτό το κοινό retrieval benchmark και δείχνει ότι τα παραδείγματα έφεραν νωρίτερα πιο χρήσιμο context· δεν αποτελεί μέτρηση επιτυχίας ενός ρομπότ σε παραγωγή.
Το diagnostic pure-LLM baseline παρήγαγε πλήρη modules και στις πέντε δοκιμές, αλλά μόνο ένα πέρασε content validation. Οι αποτυχίες περιλάμβαναν ανύπαρκτα instructions όπως DIRead και DInput, λανθασμένη χρήση του CTime() ως αριθμητικής τιμής, μη έγκυρες δηλώσεις signals, επαναδήλωση built-in constants και μη τυπική σύνταξη error handling. Το 20% αφορά μόλις αυτές τις πέντε δοκιμές και δεν πρέπει να παρουσιαστεί ως γενικό ποσοστό αστοχίας LLM.
Με retrieval grounding, και τα 21 modules πέρασαν structural validation. Η κάλυψη motion instructions έφτασε το 100%, ενώ η κάλυψη I/O ανέβηκε από 36% στο naive RAG σε 50% στο πλήρες pipeline. Σε subset δέκα full-pipeline modules, τέσσερα επισημάνθηκαν για διόρθωση λόγω ελλιπών tools ή workobjects, λάθος RAPID data structures, function που δεν έκανε compile, ελλιπών section markers, μη ασφαλών motion patterns ή υπερβολικής ταχύτητας και blending.
Κανόνας ανάγνωσης
Μην συγχωνεύετε retrieval, code quality και execution success
Τα 30 queries, τα 5 baseline modules, τα 21 grounded modules, το subset των 10 και τα simulation cases έχουν διαφορετική μονάδα ανάλυσης. Η μελέτη είναι χρήσιμη επειδή χωρίζει τα επίπεδα· μια περίληψη που τα μετατρέπει σε ένα ενιαίο «ποσοστό ακρίβειας» θα ήταν παραπλανητική.
Το σφάλμα ύψους που φάνηκε μόνο στην εκτέλεση
Στο πρώτο RobotStudio case, ένα suction tool μετέφερε κουτιά από conveyor σε pallet. Offset απελευθέρωσης +40 mm, ρυθμισμένο για πορτοκαλί κουτί ύψους 100 mm, επαναχρησιμοποιήθηκε σε πράσινο κουτί ύψους 200 mm. Το module ήταν δομικά έγκυρο και οι στόχοι προσβάσιμοι, όμως το tool-center point κατέληξε μέσα στο ψηλότερο κουτί και η βεντούζα δεν το άφησε.
Η διορθωμένη τιμή ήταν +140 mm: το αρχικό clearance των 40 mm συν τη διαφορά ύψους των 100 mm. Η αποτυχία δεν κρίθηκε απλώς από screenshot. Μετά την απενεργοποίηση της αναρρόφησης, η ροή έλεγξε I/O και scene objects. Η τοποθέτηση γινόταν δεκτή μόνο όταν το αντικείμενο έπαυε να κινείται μαζί με το εργαλείο και παρέμενε κοντά στην αναμενόμενη θέση του pallet.
Αυτό είναι παράδειγμα failure signal που συνδέεται με το πραγματικό outcome. Το πρόγραμμα δεν «πέτυχε» επειδή επέστρεψε success response ή επειδή ο controller δεν έδειξε syntax error. Πέτυχε όταν το αντικείμενο απέκτησε την αναμενόμενη ανεξάρτητη κατάσταση. Αντίστοιχα, ένας agent παραγγελιών δεν επιβεβαιώνεται μόνο από HTTP 200· χρειάζεται reconciliation με stock, payment state και το σωστό order record.
Η αλλαγή product variant και ο πέμπτος άξονας
Το δεύτερο case χρησιμοποίησε δύο πυραμίδες 14 blocks στο ίδιο simulated cell. Η πορτοκαλί παραλλαγή είχε blocks 200 × 200 × 100 mm και στόχο στο δεξί pallet. Με ανάγνωση των υπαρχόντων workobjects και των bounding boxes, το σύστημα υπολόγισε τα ύψη των στρώσεων και ολοκλήρωσε την πυραμίδα με την πρώτη προσπάθεια.
Η πράσινη παραλλαγή είχε blocks 200 × 200 × 200 mm και στόχο στο αριστερό pallet. Οι δύο πρώτες προσπάθειες απέτυχαν επειδή ορισμένοι στόχοι βρίσκονταν έξω από το feasible reach envelope. Μετά από αλλαγή στη βάση των στόχων και στο approach height, η τρίτη προσπάθεια τοποθέτησε έξι blocks αλλά ενεργοποίησε controller-reported out-of-range error στον πέμπτο άξονα.
Τα joint readings έδειξαν stored recovery pose περίπου 111,7 μοιρών για τον πέμπτο άξονα. Η τιμή περιγράφει το high-angle pose και όχι τη μέγιστη γωνία της αποτυχημένης διαδρομής. Η επιτυχής διόρθωση χρησιμοποίησε MoveAbsJ προς calibration pose με τον πέμπτο άξονα κοντά στο μηδέν και μετά MoveJ προς το ονομαστικό home, ώστε ο controller να επιλέξει ασφαλέστερη joint solution. Η τελική εκτέλεση τοποθέτησε και τα 14 blocks.
Τι δεν αποδεικνύει η μελέτη
Οι συγγραφείς χαρακτηρίζουν την αξιολόγηση προκαταρκτική. Χρησιμοποιήθηκε ένα RobotStudio cell, πέντε pure-LLM baseline trials, 21 grounded generation trials και δέκα modules με καταγεγραμμένο πλήρες semantic review. Δεν έγινε test στατιστικής σημαντικότητας και τα simulation cases λειτουργούν ως μηχανιστική απόδειξη συγκεκριμένων αποτυχιών, όχι ως καθολικό reliability benchmark.
Η ροή δεν σχεδίασε αυτόνομα το station, τα tools, τα workobjects, το I/O mapping ή τα Smart Components. Αυτά είχαν προετοιμαστεί από ειδικούς. Άνθρωπος ξεκινούσε τα tasks, επέλεγε πότε θα εκτελεστούν candidate corrections και επιβεβαίωνε το τελικό αποτέλεσμα από tool outputs και screenshots. Η σωστή διατύπωση είναι «λιγότερο χειροκίνητο debugging», όχι «αυτόνομο cell engineering».
Δεν επικυρώθηκαν safety PLC integration, welding process constraints ή multi-robot coordination. Επίσης, η γέφυρα είναι platform-specific: KUKA, FANUC ή PLC περιβάλλοντα χρειάζονται διαφορετικά tool implementations. Τέλος, οι διορθώσεις δεν αποθηκεύονταν ακόμη διαχρονικά ως hard constraints. Η ανάγκη για αξιόπιστη μνήμη θυμίζει το πρόβλημα του semantic rollback σε AI agents: το state που άφησε μια ενέργεια δεν εξαφανίζεται πάντα μαζί με το database rollback.
Η μετάφραση σε business AI agents
Η αρχιτεκτονική μπορεί να μεταφερθεί ως pattern, όχι ως απόδειξη απόδοσης σε άλλο κλάδο. Στη ρομποτική, το ασφαλές περιβάλλον είναι virtual controller και 3D cell. Σε e-commerce μπορεί να είναι staging catalog με shadow orders. Σε CRM μπορεί να είναι read-only replay πραγματικών events με masked δεδομένα. Σε marketing operations μπορεί να είναι dry run που υπολογίζει audience, budget και policy conflicts χωρίς να ενεργοποιεί καμπάνια.
Η ανάκτηση πρέπει επίσης να χωρίζεται ανά ρόλο. Policies, product data και approved examples δεν είναι το ίδιο corpus. Ένα generative QA σύστημα για εταιρικά έγγραφα χρειάζεται permissions και citations· ένας agent που εκτελεί ενέργειες χρειάζεται επιπλέον tool-level authorization, idempotency, audit log και outcome checks.
Τα δικαιώματα πρέπει να περιορίζονται ανά task. Αν ο agent χρειάζεται να δημιουργήσει πρόταση κανόνα, δεν χρειάζεται αυτομάτως publish access. Αν πρέπει να διαβάσει stock, δεν χρειάζεται write permission στον κατάλογο. Το μοντέλο του dynamic capability scoping για AI agents συμπληρώνει τη simulation λογική: πρώτα περιορίζουμε τι μπορεί να κάνει το σύστημα και μετά αξιολογούμε αν έκανε σωστά αυτό που του επιτρέψαμε.
Οι ομάδες πρέπει να ορίζουν observable acceptance criteria πριν από το pilot. «Δεν εμφάνισε error» δεν είναι business outcome. Ένα σωστό order automation πρέπει να αφήνει συνεπή payment, inventory, tax και fulfillment state. Ένα support agent πρέπει να επιστρέφει citation, να αναγνωρίζει πότε λείπει γνώση και να κάνει escalation. Ένα marketing agent πρέπει να περνά brand, legal και budget checks πριν από publish.
Pilot σε επτά βήματα πριν από την παραγωγή
Ένα ασφαλές pilot ξεκινά από μία περιορισμένη ροή με υψηλή παρατηρησιμότητα και αναστρέψιμες ενέργειες. Δεν χρειάζεται να αντιγράψει το RobotStudio· χρειάζεται να αντιγράψει τη λογική του κλειστού βρόχου: grounded πρόταση, ελεγχόμενη εκτέλεση, συγκεκριμένα σήματα, διόρθωση και ανθρώπινο gate.
Επτά βήματα για agent που δοκιμάζεται πριν ενεργήσει
Стъпка 1Ορίστε ένα στενό outcome
Επιλέξτε μία επαναλαμβανόμενη εργασία και γράψτε τι σημαίνει επιτυχία στο σύστημα αναφοράς: ποιο record αλλάζει, ποια κατάσταση αναμένεται και τι δεν πρέπει να επηρεαστεί.
Стъпка 2Χωρίστε τις πηγές γνώσης
Διατηρήστε policies, τεχνική τεκμηρίωση, master data και επικυρωμένα παραδείγματα ως διακριτά corpora με owner, έκδοση, ημερομηνία και δικαιώματα.
Стъпка 3Περιορίστε τα εργαλεία
Εκθέστε μόνο τις αναγκαίες typed actions και χωρίστε read, propose, simulate και commit. Κάθε tool χρειάζεται σαφές schema, validation και καταγραφή του caller.
Стъпка 4Χτίστε sandbox ή dry run
Αναπαράγετε τα κρίσιμα schemas και business rules με masked ή συνθετικά δεδομένα. Το περιβάλλον πρέπει να αποκαλύπτει τις αποτυχίες που σας κοστίζουν, όχι απλώς να επιστρέφει επιτυχή API response.
Стъпка 5Ορίστε failure signals
Συνδέστε logs με outcome checks: inventory mismatch, duplicate CRM owner, policy violation, budget overflow, missing citation ή αλλαγή εκτός scope. Καθορίστε severity και escalation.
Стъпка 6Μετρήστε ανά επίπεδο
Παρακολουθήστε retrieval relevance, schema validity, semantic coverage, tool success και τελικό business outcome χωριστά. Έτσι γνωρίζετε ποιο τμήμα χρειάζεται διόρθωση.
Стъпка 7Κρατήστε ανθρώπινο commit gate
Για χρήματα, προσωπικά δεδομένα, δημόσια δημοσίευση ή φυσικό εξοπλισμό, ο άνθρωπος βλέπει τη διαφορά, το evidence και το rollback plan πριν από την πραγματική ενέργεια.
Το pilot πρέπει να κλείνει με replay αποτυχιών, όχι μόνο με επίδειξη επιτυχιών. Δοκιμάστε παλιό corpus, ελλιπή record, αντικρουόμενα permissions, timeout μετά από write και διπλή εκτέλεση. Η αξία ενός agent φαίνεται στο αν το σύστημα αναγνωρίζει και περιορίζει το λάθος, όπως και σε ένα πρακτικό πρόγραμμα automation και AI η επιτυχία μετριέται στη ροή και όχι στο εντυπωσιακό demo.
Η επιχειρηματική απόφαση
Η μελέτη δεν δείχνει ότι η AI είναι έτοιμη να αναλάβει αυτόνομα μια βιομηχανική γραμμή. Δείχνει ότι η αξιοπιστία αυξάνεται όταν η πρώτη απάντηση παύει να είναι το τελικό προϊόν. Τα manuals μειώνουν τα λάθη γνώσης, τα templates δίνουν εγκεκριμένη δομή, οι structural και semantic checks εντοπίζουν διαφορετικές κατηγορίες αστοχίας και ο simulator αποκαλύπτει όσα υπάρχουν μόνο στη γεωμετρία και στην εκτέλεση.
Για μια επιχείρηση, η ώριμη ερώτηση δεν είναι «μπορεί το μοντέλο να γράψει τον κώδικα;». Είναι «μπορούμε να ελέγξουμε τι γνώση χρησιμοποίησε, ποια εργαλεία κάλεσε, πού δοκιμάστηκε, ποιο σήμα αποδεικνύει το outcome και ποιος εγκρίνει τη μετάβαση στην παραγωγή;». Αν αυτές οι απαντήσεις δεν είναι ορατές, το πρόβλημα δεν λύνεται με μεγαλύτερο prompt.
Από το AI demo στην ελεγχόμενη ροή
Σχεδιάστε automation που δοκιμάζεται πριν ενεργήσει
Η TWO DOTS χαρτογραφεί πηγές, tools, business rules, dry runs, logs και ανθρώπινα approval gates, ώστε ένα AI workflow να συνδέεται με πραγματικά συστήματα χωρίς να κρύβει το κόστος της αποτυχίας.
Τι συνδυάζει η μελέτη για MCP και RAG στη ρομποτική;
Συνδυάζει διπλή ανάκτηση από τεκμηρίωση και επικυρωμένα RAPID templates με δομικό και σημασιολογικό έλεγχο, upload σε ABB RobotStudio, εκτέλεση σε virtual controller και διόρθωση από logs, I/O, joint states και scene geometry.
Γιατί δεν αρκεί το RAG για σωστό robot code;
Το RAG μειώνει λάθη γνώσης και φέρνει σχετικά patterns, αλλά δεν γνωρίζει μόνο του αν ένας στόχος είναι reachable, αν το tool θα αφήσει το αντικείμενο ή αν μια joint configuration θα αποτύχει. Αυτά χρειάζονται έλεγχο στο συγκεκριμένο cell.
Ποιος είναι ο ρόλος του MCP στο RobotStudio;
Το MCP λειτουργεί ως ελεγχόμενη διεπαφή ανάμεσα στον client του μοντέλου και σε σαφώς ορισμένες λειτουργίες του RobotStudio. Επιτρέπει typed calls για simulation, RAPID code, diagnostics, I/O και scene data χωρίς το μοντέλο να ενσωματώνεται στον simulator.
Πόσα εργαλεία είχε η γέφυρα που αξιολογήθηκε;
Η γέφυρα της μελέτης είχε 16 MCP tools. Το δημόσιο repository έχει έκτοτε επεκταθεί, αλλά οι μεταγενέστερες δυνατότητες πρέπει να αξιολογούνται ξεχωριστά και δεν θεωρούνται αυτόματα μέρος των πειραματικών αποτελεσμάτων.
Τι βελτίωσε το δεύτερο retrieval stream;
Στο κοινό benchmark 30 queries, η προσθήκη των 106 code templates ανέβασε την precision από 0,52 σε 0,68, το recall από 0,41 σε 0,57 και το MRR από 0,58 σε 0,72 σε σύγκριση με documentation-only retrieval.
Ποιο λάθος αποκάλυψε μόνο η προσομοίωση;
Ένα release offset +40 mm που λειτουργούσε για κουτί ύψους 100 mm άφηνε το tool-center point μέσα σε κουτί ύψους 200 mm. Το module έκανε compile και οι στόχοι ήταν reachable, αλλά το αντικείμενο δεν αποδεσμευόταν.
Μπορεί η ίδια αρχιτεκτονική να χρησιμοποιηθεί σε CRM ή e-commerce;
Μπορεί να μεταφερθεί ως pattern: ελεγχόμενες πηγές, περιορισμένα tools, sandbox ή dry run, observable acceptance criteria και ανθρώπινο commit gate. Η μελέτη όμως δεν αποτελεί μέτρηση απόδοσης για CRM ή e-commerce agents.
Καταργείται ο ειδικός μηχανικός από τη διαδικασία;
Όχι. Ειδικοί προετοίμασαν το station, τα tools, τα workobjects, το I/O, το corpus και τα checks, ενώ άνθρωπος ξεκινούσε τις δοκιμές και επιβεβαίωνε τα τελικά αποτελέσματα. Ο στόχος είναι λιγότερο debugging, όχι αυτόνομο cell engineering.