Apprentissage par renforcement

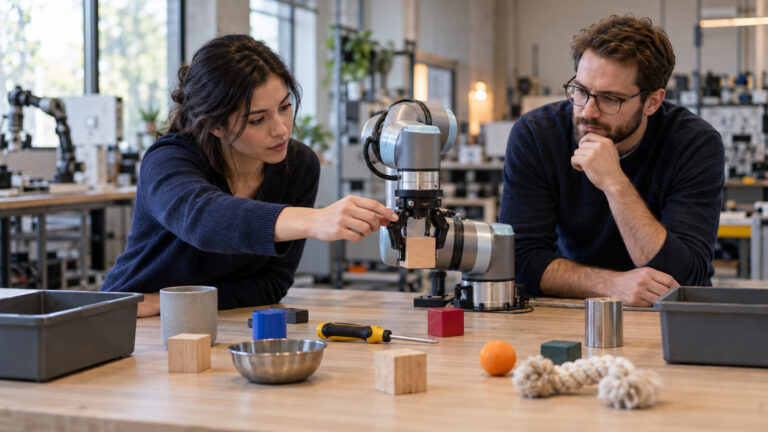
Ερευνητές καθοδηγούν ρομποτικό σύστημα για sparse reward εκπαίδευση AI

Όταν το reward σωπαίνει: hints, critics και teachers στην εκπαίδευση AI

Μια ελεγχόμενη σύγκριση 11 μεθόδων δείχνει πότε hints, distillation και critics βοηθούν την AI με sparse reward — και πώς ένα benchmark μπορεί να αντιστρέψει το συμπέρασμα.

Lire la suiteΌταν το reward σωπαίνει: hints, critics και teachers στην εκπαίδευση AI
Ομάδα ελέγχει Actor Judge Editor AI planning σε επιχειρησιακό workflow

Actor, Judge, Editor: πώς η AI μαθαίνει να σχεδιάζει χωρίς να αλλάζει τον στόχο

Το Actor–Judge–Editor μαθαίνει συμβολικό planning από solver feedback, ξεχωρίζοντας την τεχνική επιτυχία από την πιστότητα στον αρχικό στόχο.

Lire la suiteActor, Judge, Editor: πώς η AI μαθαίνει να σχεδιάζει χωρίς να αλλάζει τον στόχο
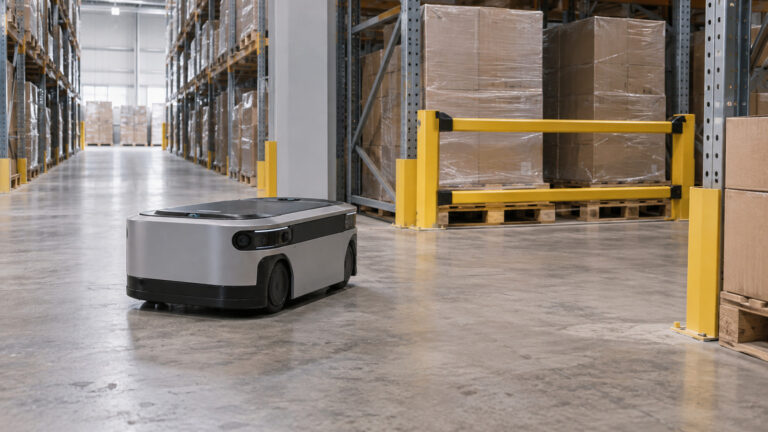
Αυτόνομο ρομπότ σε αποθήκη ως παράδειγμα σύζευξης world model, AI agent και περιβάλλοντος

World models στην AI: το κρίσιμο ερώτημα δεν είναι μόνο τι προβλέπουν

Τα world models μπορεί να αφορούν το περιβάλλον, τον agent ή την κοινή διαδικασία. Η σωστή διάκριση καθορίζει support, αξιολόγηση και ασφαλή λειτουργία.

Lire la suiteWorld models στην AI: το κρίσιμο ερώτημα δεν είναι μόνο τι προβλέπουν
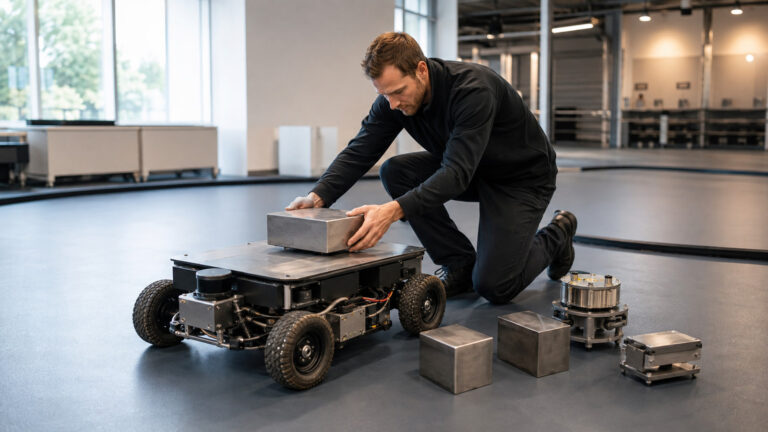
Ρομπότ σε σύνθετο περιβάλλον δοκιμών για το Transition Complexity Profile