Με πάνω από 20 χρόνια εμπειρίας, μεταμορφώνουμε την ψηφιακή σας παρουσία. Εξειδικευόμαστε στην κατασκευή ιστοσελίδων και E-Shop, το SEO και το Digital Marketing, τα ERP λογισμικά και τους έξυπνους αυτοματισμούς που απογειώνουν την επιχείρησή σας.
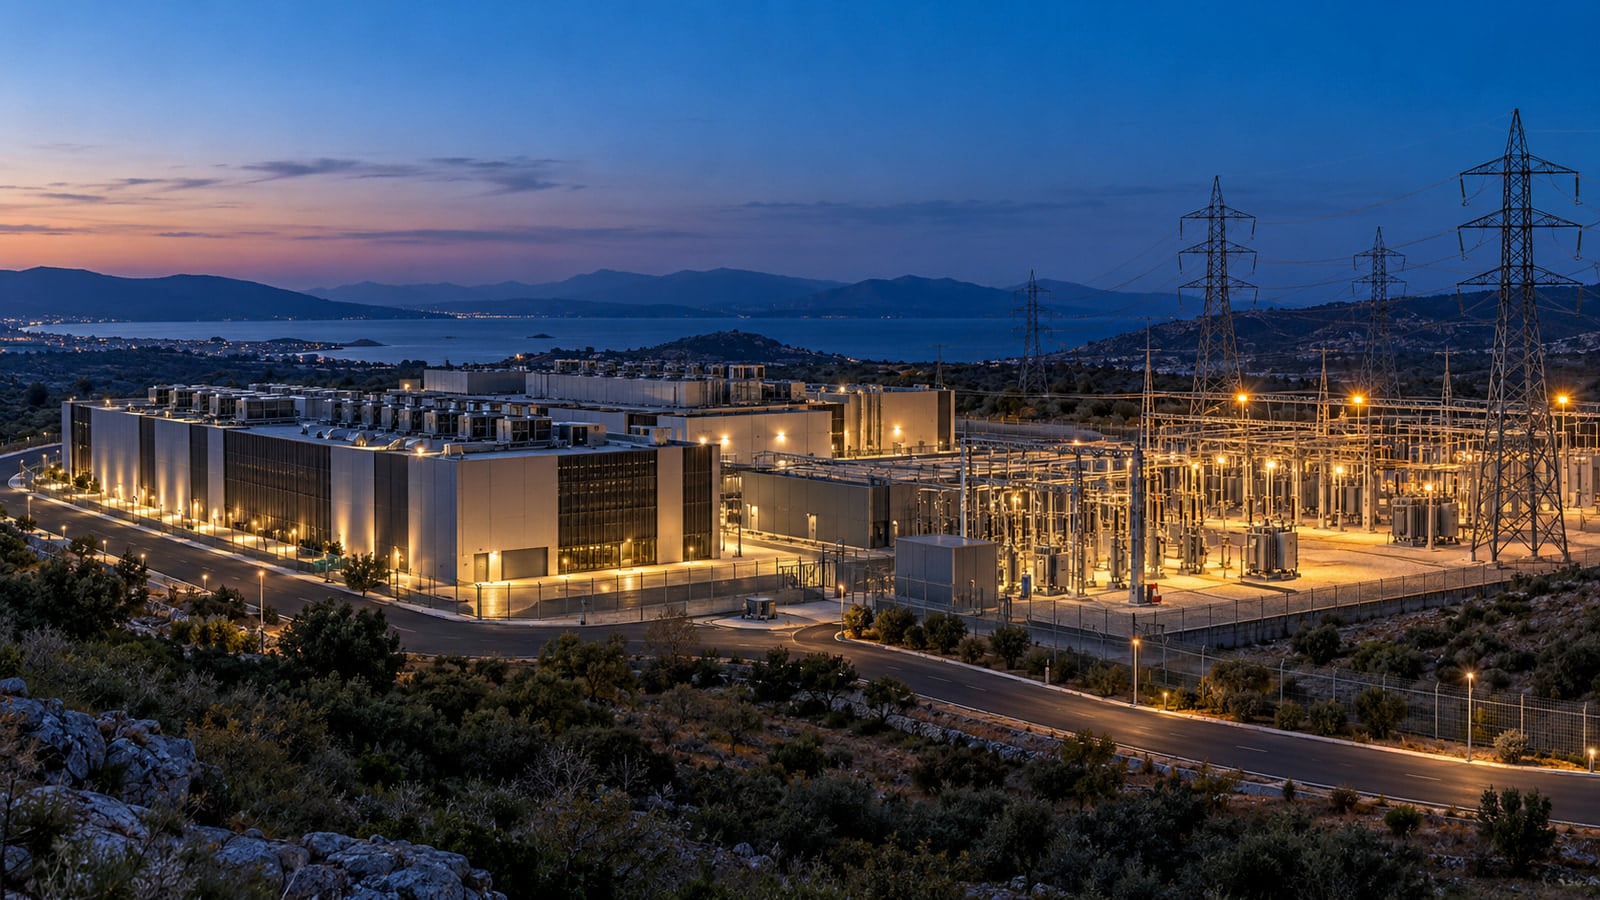
AI και cloud υποδομές: όταν το ηλεκτρικό δίκτυο γίνεται επιχειρηματικό όριο
Οι AI cloud υποδομές εξαρτώνται από ισχύ, region και χωρητικότητα. Δείτε πώς capacity planning, right-sizing και fallback μειώνουν το επιχειρηματικό ρίσκο.
Η ανθεκτική AI στρατηγική συνδέει workload, χωρητικότητα και δοκιμασμένο fallback.
Απάντηση πρώτα: οι AI cloud υποδομές δεν περιορίζονται πλέον μόνο από τα chips ή το budget. Η πραγματική χωρητικότητα εξαρτάται από διαθέσιμη ηλεκτρική ισχύ, σύνδεση στο δίκτυο, περιοχή, χρόνο αδειοδότησης και αποδοτική χρήση των πόρων. Για μια επιχείρηση, η σωστή απάντηση είναι μικρότερα και μετρήσιμα AI workloads, capacity plan 24–36 μηνών και σχεδιασμένες εναλλακτικές πριν η έλλειψη γίνει blocker.
Το cloud έκανε την υποδομή να μοιάζει άυλη: επιλέγεις region, instance ή managed service και περιμένεις ότι η χωρητικότητα θα εμφανιστεί. Πίσω από το portal, όμως, υπάρχουν data centers, μετασχηματιστές, γραμμές μεταφοράς, ψύξη, γη, άδειες και συμβόλαια ενέργειας. Η εξάπλωση της AI φέρνει ξανά αυτή τη φυσική αλυσίδα στο κέντρο της επιχειρηματικής απόφασης.
Το θέμα δεν αφορά μόνο hyperscalers. Επηρεάζει το πότε μπορεί να ξεκινήσει ένα AI project, σε ποια περιοχή θα λειτουργεί, πόσο θα κοστίζει το inference και πόσο ανθεκτική θα είναι μια ψηφιακή υπηρεσία. Για e-commerce, customer support, analytics και αυτοματισμούς, η χωρητικότητα γίνεται μέρος του product planning — όχι μια λεπτομέρεια που αφήνεται για το τέλος.
Ο David Linthicum γράφει στο InfoWorld ότι η εποχή της φαινομενικά απεριόριστης cloud χωρητικότητας τελειώνει. Η θέση του είναι άρθρο γνώμης, όχι πρόβλεψη ενός παρόχου, αλλά η κεντρική διάκριση είναι χρήσιμη: ανάπτυξη-ρεκόρ των data centers δεν σημαίνει υποχρεωτικά ότι κάθε υπηρεσία θα είναι διαθέσιμη άμεσα, σε κάθε region και στην τιμή που έχει προβλέψει ο πελάτης.
Η ζήτηση για model training, inference, analytics, vector databases και high-performance storage αυξάνεται μαζί. Ταυτόχρονα, ένα νέο campus χρειάζεται πραγματική σύνδεση στο δίκτυο και εξοπλισμό που δεν παραδίδεται με τον ρυθμό ενός software release. Η αγορά cloud πόρων μπορεί να είναι ψηφιακή, αλλά η παραγωγή τους παραμένει βαριά υποδομή.
Αυτό εξηγεί γιατί η συζήτηση για neoclouds και AI υποδομές δεν εξαντλείται στην τιμή μιας GPU ανά ώρα. Η διαθεσιμότητα, η ενεργειακή τροφοδοσία, το δίκτυο και η επιχειρησιακή υποστήριξη είναι μέρος του ίδιου προϊόντος.
Τι δείχνουν τα δεδομένα για ενέργεια και AI
Η International Energy Agency καταγράφει ότι η παγκόσμια κατανάλωση ηλεκτρικής ενέργειας των data centers αυξήθηκε κατά 17% το 2025, ενώ στα AI-focused data centers η αύξηση ήταν 50%. Στην ενημερωμένη κεντρική της πρόβλεψη, η συνολική κατανάλωση ανεβαίνει από 485 TWh το 2025 σε περίπου 950 TWh το 2030 και αντιστοιχεί τότε σε περίπου 3% της παγκόσμιας ζήτησης ηλεκτρισμού.
Ενεργειακό αποτύπωμα data centers
Η κλίμακα της ζήτησης έως το 2030
Οι τιμές είναι παγκόσμιες προβολές της IEA και όχι πρόβλεψη κόστους ή διαθεσιμότητας για μια συγκεκριμένη cloud region.
485 TWhεκτιμώμενη κατανάλωση ηλεκτρισμού των data centers το 2025
950 TWhκεντρική πρόβλεψη για τη συνολική κατανάλωση το 2030
≈3%μερίδιο της παγκόσμιας ζήτησης ηλεκτρισμού το 2030
3×προβλεπόμενη αύξηση κατανάλωσης στα AI-focused data centers, 2025–2030
Πηγή: International Energy Agency, «Key Questions on Energy and AI».
Το εύρος και η γεωγραφία έχουν σημασία. Η IEA σημειώνει ότι τα bottlenecks σε ηλεκτρική υποδομή, chips, χρηματοδότηση και αδειοδοτήσεις περιορίζουν τα πιο επιθετικά βραχυπρόθεσμα σενάρια. Παράλληλα, η τοπική κοινωνική αποδοχή επηρεάζεται από ανησυχίες για κόστος ενέργειας και περιβαλλοντικές επιπτώσεις. Το «υπάρχει αρκετή ενέργεια παγκοσμίως» δεν απαντά αν υπάρχει επαρκής ισχύς στη σωστή θέση και στον σωστό χρόνο.
Γιατί η ισχύς είναι διαφορετικό bottleneck
Ένα software bottleneck μπορεί συχνά να αντιμετωπιστεί με νέο deployment ή αλλαγή κώδικα. Η ενεργειακή χωρητικότητα απαιτεί μεταφορά και διανομή, μετασχηματιστές, αδειοδοτήσεις, γη και συντονισμό πολλών φορέων. Η IEA επισημαίνει ότι η ταχύτητα της AI συγκρούεται με τον βραδύτερο ρυθμό των φυσικών, κοινωνικών και ρυθμιστικών συστημάτων που τη στηρίζουν.
Η τοπική παραγωγή δεν καταργεί αυτόματα τον περιορισμό. Μπορεί να προσθέσει ερωτήματα για καύσιμο, εκπομπές, νερό, αξιοπιστία, αποθήκευση και νέες άδειες. Η IEA εκτιμά ότι αξιόπιστη onsite παραγωγή με φυσικό αέριο για μεταβλητό φορτίο data center μπορεί να απαιτεί εγκατεστημένη ισχύ 30% έως 70% πάνω από τη ζήτηση. Αυτό είναι ανάλυση για data centers μεγάλης κλίμακας, όχι σύσταση να κατασκευάσει μια επιχείρηση δική της μονάδα.
Τα ευρήματα του U.S. Department of Energy δείχνουν την ίδια πίεση σε εθνική κλίμακα: τα αμερικανικά data centers κατανάλωσαν περίπου 4,4% του ηλεκτρισμού το 2023, με προβολή 6,7% έως 12% για το 2028. Οι αριθμοί αφορούν τις ΗΠΑ και δεν πρέπει να μεταφέρονται αυτούσιοι στην Ελλάδα ή στην Ευρώπη, όμως δείχνουν γιατί το grid planning έχει γίνει μέρος της τεχνολογικής στρατηγικής.
Πώς μεταφράζεται σε επιχειρηματικό ρίσκο
Για τον τελικό πελάτη, ο περιορισμός σπάνια εμφανίζεται ως μήνυμα «δεν υπάρχει ηλεκτρική ισχύς». Εμφανίζεται ως έλλειψη συγκεκριμένου instance, quota που δεν εγκρίνεται, καθυστέρηση region, υψηλότερη τιμή ή ανάγκη μεταφοράς δεδομένων. Ένα launch μπορεί να εξαρτάται από capacity που δεν είχε δεσμευτεί, ενώ το migration plan υποθέτει ότι όλες οι εξειδικευμένες υπηρεσίες έχουν ισοδύναμη διαθεσιμότητα παντού.
Σε e-commerce, ένα promotion μπορεί να αυξήσει ταυτόχρονα traffic, search, recommendation inference, fraud checks και customer support. Στα analytics, ένα deadline μπορεί να συμπυκνώσει batch jobs σε λίγες ώρες. Σε generative AI, το κόστος και η χωρητικότητα αλλάζουν ανάλογα με model size, context, concurrency και caching. Η επιχείρηση χρειάζεται να μοντελοποιεί το πραγματικό peak workload, όχι ένα μέσο μηνιαίο νούμερο.
Η ανάλυση για το κόστος της AI στις επιχειρήσεις συμπληρώνει την εικόνα: η τιμή ανά κλήση ή ανά ώρα δεν αρκεί χωρίς δεδομένα για utilization, latency, αποθήκευση, δίκτυο και ανθρώπινη λειτουργία.
Cloud budget
Απαντά πόσα χρήματα εγκρίνονται, αλλά όχι αν η σωστή GPU, περιοχή ή υπηρεσία θα υπάρχει στο επιθυμητό παράθυρο.
Οικονομικό όριοΧωρίς εγγύηση capacity
Capacity plan
Χαρτογραφεί workload, χρονισμό, region, quota, εξειδικευμένους πόρους και εναλλακτικές πριν από τη δέσμευση του roadmap.
24–36 μήνεςΣενάρια αιχμής
Placement strategy
Ορίζει ποια workloads μένουν σε μία υπηρεσία και ποια μπορούν να μετακινηθούν με αποδεκτό κόστος, latency και πολυπλοκότητα.
Σχεδιασμένο fallbackΌχι τυφλό multi-cloud
Τα υπερσχεδιασμένα AI projects πιέζονται πρώτα
Ο Linthicum αναφέρει, από τη δική του εμπειρία, οργανισμούς που χρησιμοποιούν 10 έως 20 φορές περισσότερη υποδομή από όση θεωρεί αναγκαία για το πρόβλημα. Δεν πρόκειται για ανεξάρτητο benchmark και δεν πρέπει να μετατραπεί σε γενικό ποσοστό σπατάλης. Η προειδοποίηση, όμως, είναι σαφής: μεγάλα GPU clusters, custom fine-tuning και data pipelines συχνά επιλέγονται πριν οριστεί με ακρίβεια το επιχειρηματικό αποτέλεσμα.
Ένα AI project πρέπει να αρχίζει από την απόφαση που βελτιώνει. Για ticket routing μπορεί να αρκεί classifier. Για αναζήτηση πολιτικής επιστροφών μπορεί να αρκεί retrieval πάνω σε καλά δομημένο περιεχόμενο. Για περίληψη feedback μπορεί να αρκεί μικρότερο μοντέλο με περιορισμένο context. Η μεγαλύτερη αρχιτεκτονική δεν είναι αυτομάτως η πιο αξιόπιστη ή η πιο χρήσιμη.
Αυτό δεν σημαίνει ότι τα μεγάλα μοντέλα δεν έχουν θέση. Σημαίνει ότι η εξειδικευμένη χωρητικότητα πρέπει να αποδίδεται σε workloads που αποδεικνύουν την ανάγκη της. Η πρακτική σύγκριση με τα GPU neoclouds το 2026 βοηθά να διαχωριστεί η ωριαία τιμή από SLA, διασύνδεση, αποθήκευση, support και πραγματική διαθεσιμότητα.
Frugal architecture χωρίς μικρότερη φιλοδοξία
Frugal architecture σημαίνει ότι κάθε πόρος δικαιολογείται από το workload. Χρησιμοποιεί το μικρότερο μοντέλο που περνά τα πραγματικά quality tests, βελτιστοποιεί inference και context, επαναχρησιμοποιεί embeddings ή features όπου είναι ασφαλές, προγραμματίζει batch jobs εκτός αιχμής και απενεργοποιεί idle περιβάλλοντα.
Η επίσημη τεκμηρίωση του Google Cloud Well-Architected Framework προτείνει να συνδέονται οι τεχνικές επιλογές με επιχειρηματικούς στόχους και KPIs, να μετρώνται χωριστά training, inference, storage και network costs και να υπάρχει ιδιοκτήτης για κόστος και όφελος. Προτείνει επίσης managed services και pretrained models όπου ταιριάζουν, αντί για περιττή επανάληψη της ίδιας υποδομής.
Η εξοικονόμηση δεν είναι μόνο οικονομική. Μικρότερο context, caching, λιγότερες μετακινήσεις δεδομένων και καλύτερο utilization περιορίζουν και την ενεργειακή ένταση. Οι αρχές του Slow AI δείχνουν πώς η ποιότητα, η ταχύτητα και η βιωσιμότητα μπορούν να αξιολογούνται μαζί αντί να αντιμετωπίζονται ως άσχετες συζητήσεις.
Κανόνας πριν από το scale
Δώστε τη σπάνια υποδομή μόνο στο workload που αποδεικνύει ότι τη χρειάζεται
Συγκρίνετε baseline χωρίς generative AI, μικρό και μεγάλο μοντέλο, retrieval, caching και batch scheduling πάνω στα ίδια quality, latency, cost και capacity criteria. Κλιμακώστε την επιλογή που περνά το πραγματικό task — όχι εκείνη που εντυπωσιάζει περισσότερο στο architecture diagram.
Hybrid και multi-region ως επιλογές τοποθέτησης
Η hybrid αρχιτεκτονική επιστρέφει ως πρακτική capacity strategy. Κάποια workloads ταιριάζουν στο public cloud, άλλα σε colocation ή ιδιόκτητη υποδομή, ενώ μερικά μπορούν να μετακινούνται ανάμεσα σε regions όταν αλλάζει διαθεσιμότητα, latency ή τιμή. Η αξία δεν βρίσκεται στο να λειτουργούν όλα παντού, αλλά στο να υπάρχει ρεαλιστική εναλλακτική για τα κρίσιμα σημεία.
Η φορητότητα έχει κόστος. Διαφορετικά APIs, data gravity, egress, identity, observability και compliance μπορούν να κάνουν ένα θεωρητικό fallback άχρηστο την ώρα της ανάγκης. Η στρατηγική cloud repatriation και workload placement χρειάζεται να ξεκινά από συγκεκριμένα workloads και όχι από γενική θέση υπέρ ή κατά του cloud.
Για κάθε κρίσιμο workload, η ομάδα πρέπει να γνωρίζει το recovery path: ποια δεδομένα μετακινούνται, πόσο χρόνο απαιτούν, ποια λειτουργία υποβαθμίζεται προσωρινά και ποιος εγκρίνει την αλλαγή. Ένα fallback που δεν έχει δοκιμαστεί είναι απλώς υπόθεση.
Capacity plan 24–36 μηνών
Το InfoWorld προτείνει ορίζοντα 24 έως 36 μηνών για AI, analytics και data platforms. Δεν πρόκειται για ακριβή πρόβλεψη ζήτησης. Είναι ένας αρκετά μεγάλος ορίζοντας ώστε procurement, architecture, finance και product να δουν έγκαιρα ποια projects ανταγωνίζονται για εξειδικευμένη χωρητικότητα.
Το plan πρέπει να διαχωρίζει training, fine-tuning, batch inference, real-time inference, storage και network. Χρειάζεται επίσης να καταγράφει regions, quotas, εποχικές αιχμές, data residency, latency στόχους και exit criteria. Σε κάθε γραμμή, η τεχνική ανάγκη συνδέεται με μετρήσιμο business outcome και με απόφαση για το τι συμβαίνει αν ο πόρος δεν είναι διαθέσιμος.
Για μικρότερες επιχειρήσεις, αυτό δεν σημαίνει πρόβλεψη σε επίπεδο megawatt. Σημαίνει χάρτη εξαρτήσεων: ποιο SaaS ή API είναι κρίσιμο, ποια υπηρεσία έχει εναλλακτική, ποια καμπάνια δημιουργεί peak, ποιο μοντέλο μπορεί να αντικατασταθεί και ποια δεδομένα δεν μπορούν να αλλάξουν περιοχή.
Πλάνο εφαρμογής σε επτά βήματα
Το πρακτικό ζητούμενο είναι να μετατραπεί η αβεβαιότητα της χωρητικότητας σε ελεγχόμενες επιλογές. Το παρακάτω πλάνο συνδέει το business case με workload, υποδομή και fallback πριν από μια μεγάλη δέσμευση.
Από το AI use case σε ανθεκτικό capacity plan
Βήμα 1Ορίστε την επιχειρηματική απόφαση
Περιγράψτε ποια ενέργεια βελτιώνει το workload, ποιο baseline αντικαθιστά και ποιο αποτέλεσμα δικαιολογεί κόστος και εξειδικευμένη χωρητικότητα.
Βήμα 2Μετρήστε το πραγματικό προφίλ φορτίου
Καταγράψτε concurrency, latency, tokens ή samples, data transfer, storage, ώρες αιχμής και εποχικότητα αντί να σχεδιάζετε με ένα γενικό μηνιαίο σύνολο.
Βήμα 3Δοκιμάστε τη μικρότερη επαρκή λύση
Συγκρίνετε rules, search, retrieval, μικρότερο μοντέλο και μεγαλύτερο μοντέλο στο ίδιο validation set, με κοινά quality και cost thresholds.
Βήμα 4Χαρτογραφήστε region και quota
Ελέγξτε πού βρίσκονται δεδομένα και χρήστες, ποιο quota είναι εγκεκριμένο και αν η εξειδικευμένη υπηρεσία παρέχεται πράγματι στις απαιτούμενες περιοχές.
Βήμα 5Σχεδιάστε εναλλακτική τοποθέτηση
Ορίστε αν το workload μπορεί να μετακινηθεί σε άλλο region, πάροχο ή τυπική υποδομή και ποια υποβάθμιση λειτουργίας είναι αποδεκτή προσωρινά.
Βήμα 6Βάλτε όρια κατανάλωσης και exit criteria
Χρησιμοποιήστε budgets, rate limits, alerts, idle shutdown και σαφή κριτήρια παύσης όταν το κόστος ή το utilization αποκλίνει από το business case.
Βήμα 7Δοκιμάστε το fallback πριν από την αιχμή
Εκτελέστε ελεγχόμενο failover, μετρήστε χρόνο και απώλειες λειτουργικότητας και ενημερώστε runbook, owners και επικοινωνία πριν από launch ή μεγάλη καμπάνια.
Όταν το use case αφορά αυτοματοποίηση διαδικασιών, οι Αυτοματισμοί Επιχειρήσεων & AI χρειάζονται τα ίδια όρια: μετρήσιμο αποτέλεσμα, παρατηρησιμότητα, budget και επιστροφή σε ασφαλή χειροκίνητη λειτουργία.
Τα metrics που χρειάζεται η διοίκηση
Η διοίκηση δεν χρειάζεται ένα μόνο dashboard κόστους. Χρειάζεται να βλέπει τέσσερις διαφορετικές διαστάσεις: business outcome, ποιότητα, απόδοση και capacity risk. Για παράδειγμα, ένα customer-support workload μπορεί να μετρά resolution quality και επανεπαφές, μαζί με latency, κόστος ανά επιλυμένο αίτημα, peak concurrency και ποσοστό χρόνου όπου πλησιάζει quota.
Τα unit economics πρέπει να ακολουθούν την πραγματική εργασία. Το κόστος ανά εκατομμύριο tokens δεν δείχνει πόσο κοστίζει μια σωστή επίλυση όταν υπάρχουν retries, retrieval, guardrails, logs και ανθρώπινος έλεγχος. Αντίστοιχα, υψηλό GPU utilization δεν αποδεικνύει επιχειρηματική αξία όταν το workload δεν βελτιώνει το αποτέλεσμα που υποσχέθηκε.
Ένα χρήσιμο review εξετάζει τουλάχιστον: success rate στο πραγματικό task, p95 latency, κόστος ανά επιτυχημένη έκβαση, utilization, quota headroom, αποτυχίες ανά region, χρόνο fallback και κατανάλωση δεδομένων. Τα thresholds συμφωνούνται πριν από το scale, ώστε η ομάδα να μη μετακινεί τον στόχο μετά από μια ακριβή υλοποίηση.
Τι πρέπει να κρατήσει η επιχείρηση
Η αύξηση της ενεργειακής ζήτησης δεν σημαίνει ότι το cloud ή η AI παύουν να είναι σωστές επιλογές. Σημαίνει ότι το capacity δεν πρέπει να θεωρείται απεριόριστο και άμεσα διαθέσιμο. Τα δεδομένα της IEA και του DOE τεκμηριώνουν την κλίμακα της πίεσης, ενώ η άποψη του InfoWorld μεταφράζει αυτή την πίεση σε πρακτική αρχιτεκτονική προειδοποίηση.
Η ώριμη απόφαση συνδέει workload, business outcome, model size, δεδομένα, region, quota, ενέργεια και fallback. Η επιχείρηση που κάνει αυτή τη σύνδεση νωρίς μπορεί να καινοτομήσει ταχύτερα, επειδή δεν εξαρτά ένα κρίσιμο launch από χωρητικότητα που δεν έχει ελέγξει.
Το ουσιαστικό ερώτημα αλλάζει: όχι «πόση AI μπορούμε να αγοράσουμε;», αλλά «ποια AI χρειάζεται πραγματικά το αποτέλεσμα, πού μπορεί να λειτουργήσει και τι θα κάνουμε αν ο προτιμώμενος πόρος δεν είναι διαθέσιμος;». Εκεί αρχίζει η ανθεκτική cloud στρατηγική.
Υποδομή που ακολουθεί το πραγματικό workload
Σχεδιάστε hosting και τεχνική υποστήριξη με μετρήσιμη χωρητικότητα και fallback
Η TWO DOTS συνδέει απαιτήσεις απόδοσης, ασφάλειας και διαθεσιμότητας με την κατάλληλη υποδομή, παρακολούθηση και υποστήριξη για το website, το e-shop ή την επιχειρησιακή εφαρμογή σας.
Γιατί η ηλεκτρική ισχύς περιορίζει τις AI cloud υποδομές;
Επειδή κάθε AI workload εκτελείται σε φυσικά data centers που χρειάζονται grid connection, μετασχηματιστές, ψύξη και άδειες. Αυτές οι υποδομές αναπτύσσονται πιο αργά από το software και η διαθέσιμη ισχύς δεν βρίσκεται πάντα στην απαιτούμενη περιοχή.
Σημαίνει αυτό ότι τελειώνει η ανάπτυξη του cloud;
Όχι. Η ζήτηση και οι επενδύσεις συνεχίζονται. Η αλλαγή είναι ότι μια επιχείρηση δεν μπορεί να θεωρεί δεδομένη την άμεση διαθεσιμότητα κάθε GPU, region ή εξειδικευμένης υπηρεσίας στην τιμή που είχε προβλέψει.
Τι είναι ένα cloud capacity plan;
Είναι πρόβλεψη των πραγματικών workloads, των περιόδων αιχμής, των regions, των quotas και των εξειδικευμένων πόρων που θα απαιτηθούν, μαζί με εναλλακτικές τοποθέτησης και σαφείς επιχειρηματικούς owners.
Γιατί προτείνεται ορίζοντας 24–36 μηνών;
Επειδή δίνει χρόνο σε architecture, procurement, finance και product να εντοπίσουν έγκαιρα συγκρούσεις για GPUs, storage ή regions. Δεν είναι ακριβής πρόβλεψη· είναι ορίζοντας σχεδιασμού και αναθεώρησης σεναρίων.
Τι σημαίνει frugal architecture για ένα AI project;
Σημαίνει χρήση της μικρότερης λύσης που περνά τα πραγματικά quality tests, με βελτιστοποιημένο inference, caching, κατάλληλο scheduling, περιορισμό idle πόρων και μέτρηση κόστους ανά επιτυχημένο αποτέλεσμα.
Χρειάζεται κάθε επιχείρηση multi-cloud;
Όχι. Χρειάζεται επιλεγμένη φορητότητα μόνο για workloads όπου το όφελος δικαιολογεί data transfer, διαφορετικά APIs και λειτουργική πολυπλοκότητα. Για άλλα workloads, ένα δοκιμασμένο fallback στην ίδια πλατφόρμα μπορεί να είναι καλύτερο.
Ποια metrics δείχνουν αν ένα AI workload είναι σωστά διαστασιολογημένο;
Χρειάζονται μαζί quality ή success rate, p95 latency, κόστος ανά επιτυχημένη έκβαση, utilization, quota headroom, peak concurrency, αποτυχίες ανά region και χρόνος μετάβασης στο fallback.
Ποιο είναι το πρώτο πρακτικό βήμα για μια μικρότερη επιχείρηση;
Να επιλέξει ένα συγκεκριμένο AI use case, να μετρήσει το πραγματικό peak load και να συγκρίνει rules, retrieval, μικρό και μεγάλο μοντέλο στο ίδιο validation set πριν δεσμευτεί σε ακριβή ή δύσκολα διαθέσιμη υποδομή.