AI infrastructure

Μηχανικοί αξιολογούν GPU servers και μνήμη για το κόστος LLM serving
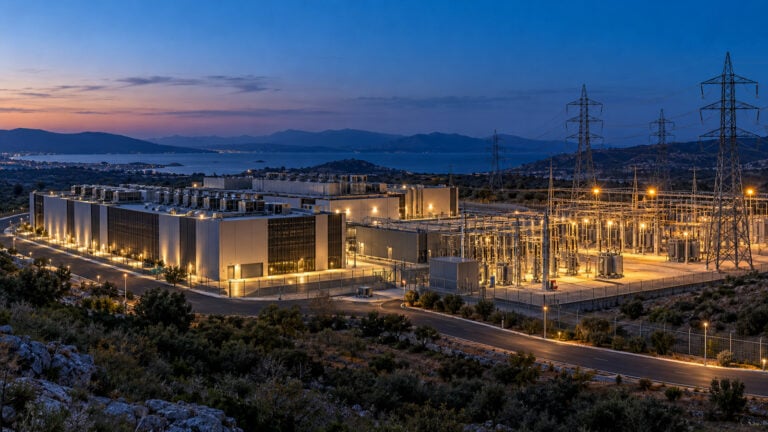
Data center και ηλεκτρικό δίκτυο για AI cloud υποδομές

AI και cloud υποδομές: όταν το ηλεκτρικό δίκτυο γίνεται επιχειρηματικό όριο

Οι AI cloud υποδομές εξαρτώνται από ισχύ, region και χωρητικότητα. Δείτε πώς capacity planning, right-sizing και fallback μειώνουν το επιχειρηματικό ρίσκο.

Прочетете повечеAI και cloud υποδομές: όταν το ηλεκτρικό δίκτυο γίνεται επιχειρηματικό όριο
Μηχανικός συντονίζει υποδομή για SAEM MoE inference

SAEM: πώς τα στάδια συλλογισμού μειώνουν το κόστος των MoE μοντέλων

Το SAEM οργανώνει το MoE inference ανά reasoning stage για να μειώσει μεταφορές, cache churn και fragmented kernels. Τι έδειξε και πώς ελέγχεται σε production.

Прочетете повечеSAEM: πώς τα στάδια συλλογισμού μειώνουν το κόστος των MoE μοντέλων
GPU инфраструктура за KVBoost и повторно използване на KV кеша в LLM

KVBoost: по-бързи LLM, когато общото съдържание не се намира в началото

KVBoost използва повторно блокове от KV кеша извън общия префикс, като използва „seam repair“ и контролиран бюджет на паметта.

Прочетете повечеKVBoost: по-бързи LLM, когато общото съдържание не се намира в началото
Αξιολόγηση υποδομής GPU neocloud από τεχνική ομάδα σε data center

GPU neoclouds το 2026: τι αγοράζεις πραγματικά πέρα από την τιμή ανά ώρα

Τα GPU neoclouds δεν συγκρίνονται μόνο στην τιμή ανά ώρα. Δείτε workload, clusters, ισχύ, SLA, συμβόλαια και πραγματικό κόστος πριν από την επιλογή provider.

Прочетете повечеGPU neoclouds το 2026: τι αγοράζεις πραγματικά πέρα από την τιμή ανά ώρα
Μηχανικός αξιολογεί speculative decoding με DSpark σε server και edge laptop

Speculative decoding με DSpark: πώς το AI απαντά γρηγορότερα χωρίς να αλλάζει αποτέλεσμα

Το speculative decoding με DSpark επιταχύνει το LFM2.5 χωρίς αλλαγή της greedy εξόδου. Δείτε πώς λειτουργεί, τι έδειξαν H100 και M4 Max και πώς σχεδιάζεται ασφαλές production pilot.

Прочетете повечеSpeculative decoding με DSpark: πώς το AI απαντά γρηγορότερα χωρίς να αλλάζει αποτέλεσμα