September 2026

Ερευνητής συγκρίνει διαφορετικές διαμορφώσεις για αξιόπιστο AI benchmark harness

Δεν υπάρχει ουδέτερο AI benchmark: πώς το harness αλλάζει τον νικητή

Νέα μελέτη δείχνει ότι 26 έγκυρα evaluation harnesses μπορούν να αλλάξουν δραστικά τα scores και τον νικητή ενός LLM leaderboard. Τι σημαίνει για τις επιχειρήσεις.

Read MoreΔεν υπάρχει ουδέτερο AI benchmark: πώς το harness αλλάζει τον νικητή
Ερευνητές ελέγχουν υποδομή για monitoring των activations σε LLMs

Μπορούν τα LLMs να κρύψουν τη σκέψη τους; Το benchmark που μετρά τον έλεγχο των activations

Το Activation Controllability Benchmark δείχνει ότι πολλά LLMs αλλάζουν το εσωτερικό τους σήμα με οδηγία, άρα το monitoring χρειάζεται layered safeguards.

Read MoreΜπορούν τα LLMs να κρύψουν τη σκέψη τους; Το benchmark που μετρά τον έλεγχο των activations
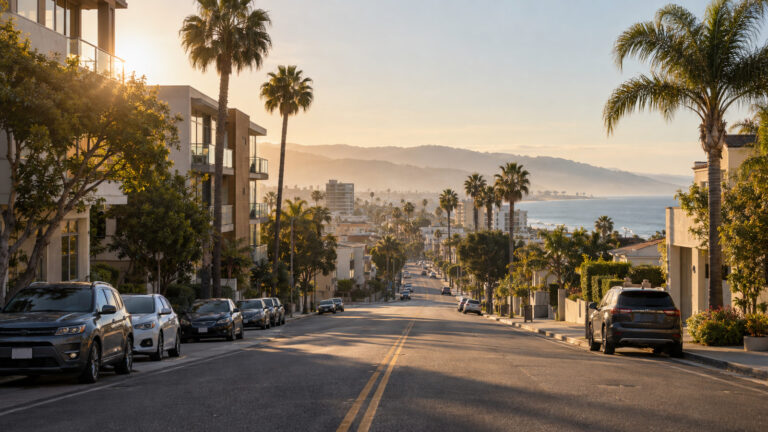
Αστικό τοπίο για CLIP και περιφερειακό γεωεντοπισμό

Τι μαθαίνει το CLIP για μια πόλη; Η προσαρμογή αποκαλύπτει τη δύναμη της σκηνής

Η προσαρμογή του CLIP βελτιώνει τον περιφερειακό γεωεντοπισμό, αλλά το scene configuration και το train–test overlap καθορίζουν την ερμηνεία.

Read MoreΤι μαθαίνει το CLIP για μια πόλη; Η προσαρμογή αποκαλύπτει τη δύναμη της σκηνής
Ομάδα ελέγχει Actor Judge Editor AI planning σε επιχειρησιακό workflow

Actor, Judge, Editor: πώς η AI μαθαίνει να σχεδιάζει χωρίς να αλλάζει τον στόχο

Το Actor–Judge–Editor μαθαίνει συμβολικό planning από solver feedback, ξεχωρίζοντας την τεχνική επιτυχία από την πιστότητα στον αρχικό στόχο.

Read MoreActor, Judge, Editor: πώς η AI μαθαίνει να σχεδιάζει χωρίς να αλλάζει τον στόχο